数据仓库为什么要分层:把数据加工拆成 ODS、DWD、DWS、ADS 四道工序
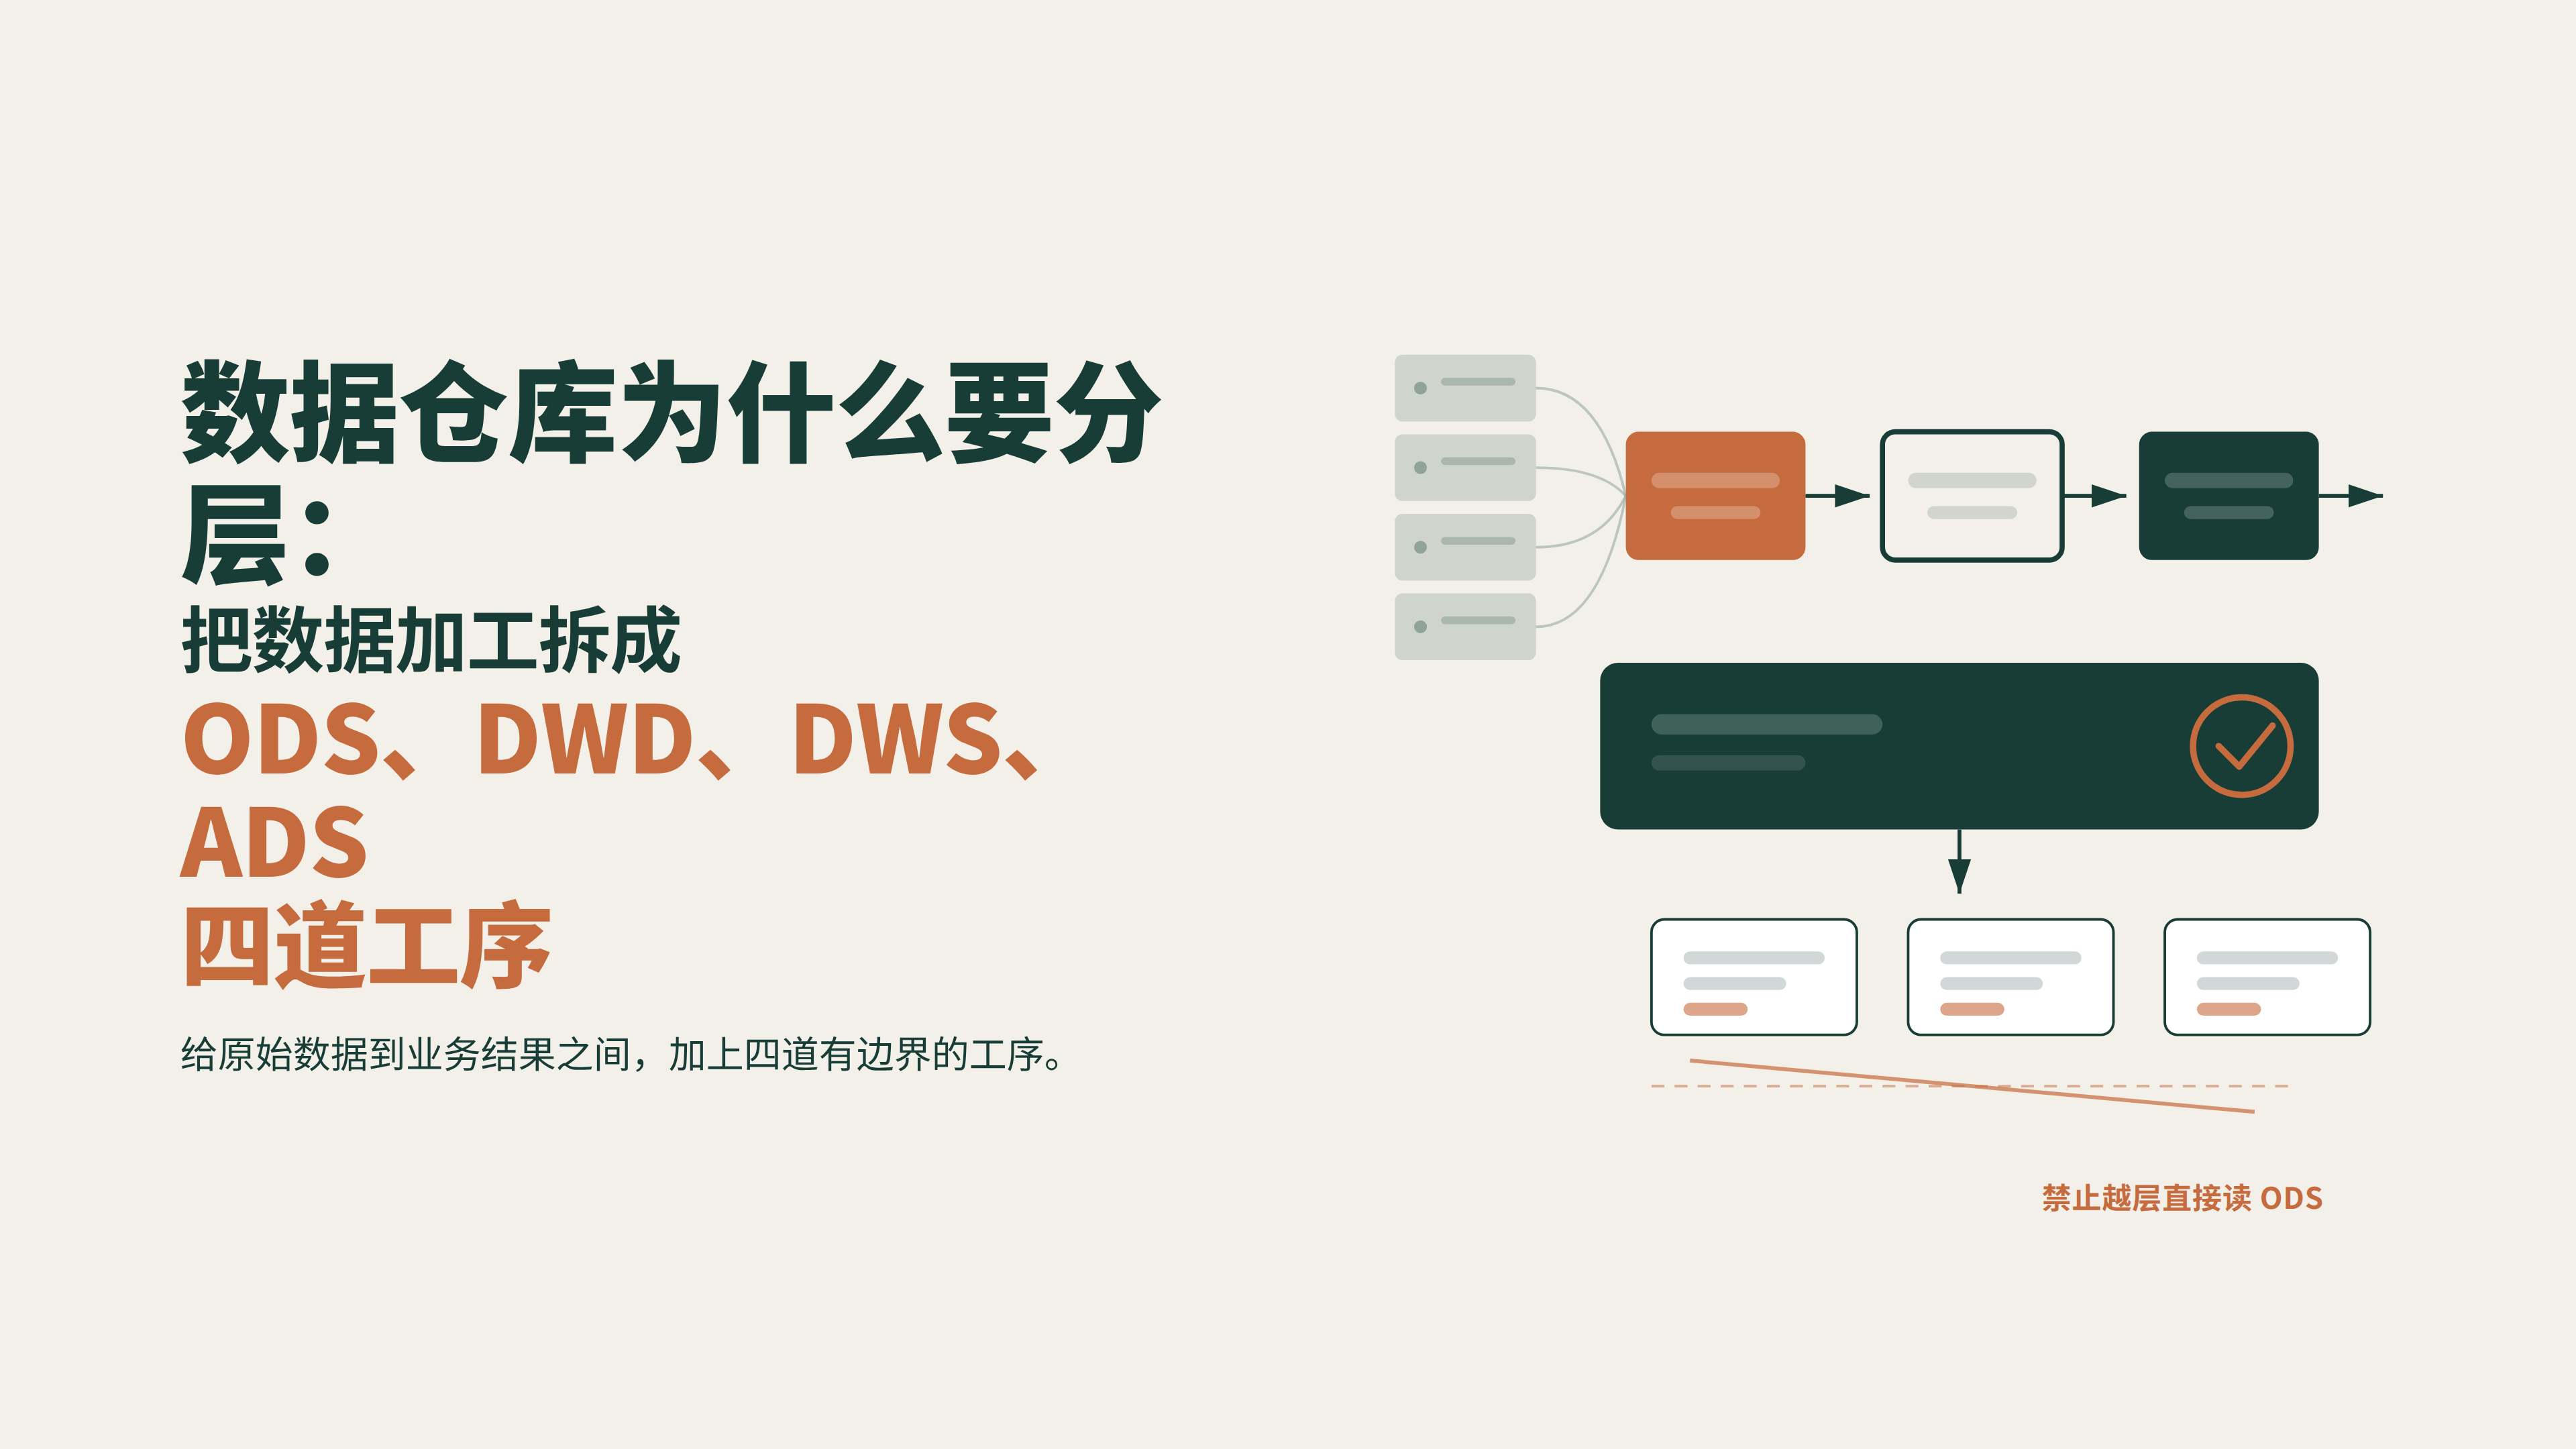
一段 SQL 就能从原始数据中算出销售日报,为什么还要把数据加工拆成 ODS、DWD、DWS、ADS 四层?数据仓库分层解决的是一个很具体的问题:同一笔订单的销售额,运营看板、财务系统、活动复盘三张报表能算出三个不同的数。分层不是要把 ODS、DWD、DWS、ADS 这几个缩写背下来,而是把"从原始数据到业务结果"这条路拆成几道有边界的工序:先把源数据原样保留,再整理成一条记录一个意思的明细,接着把公共口径沉淀成汇总,最后面向业务做一次组装。拆开之后,每一道工序只管自己那一段,公共指标算一次、大家复用,出了问题也能定位到具体环节。
三个报表三种销售额:数据加工没有边界会怎样
团队搭第一版数据看板时,通常是这么干的:谁要什么指标,就写一条 SQL,直接去业务库或原始表里算。
订单、商品、支付、退款散落在几张源表里。运营想看"昨天卖了多少",写一条 SUM(order_amount),拿的是下单金额;财务对账要看"实收多少",拿支付表里的 pay_amount 再减掉退款;活动复盘要看"活动带来多少成交",又按自己的口径算一遍。
三张报表跑出来:运营说 128 万,财务说 125 万,活动组说 123 万。这三个数没有一个算错了:下单额、实收额、扣掉退款后的成交额,本来就是三个不同的问题。真正的问题是,每张报表都自己从原始表重新加工一遍,口径各搞各的,没有一处把"销售额到底怎么算"统一起来。
没有分层时,数据加工就是这个样子:原始数据和结果表混在一起,同一个指标被反复、用不同口径计算,报表之间口径打架,需求一变整条链路都要跟着返工。分层要做的,就是把这个过程拆成几道有边界的工序。
四道工序:把数据从原始态一路加工到服务态
把数据分为五层:ODS(数据接入层)、DIM(公共维度层)、DWD(明细数据层)、DWS(汇总数据层)、ADS(应用数据层)。这五层可以看成四道流水工序,加一条贯穿始终的维度线:
- 第一道工序 ODS,把源数据原样保留;
- 第二道工序 DWD,把数据整理成一条记录一个意思的明细;
- 第三道工序 DWS,把公共口径沉淀成汇总数据;
- 第四道工序 ADS,面向业务做最后一次组装。
维度层 DIM 不单独占一道工序,而是从第二道工序开始被明细和汇总反复引用,负责把"谁、什么、哪一天"这些分析口径统一起来。整个链路长这样:
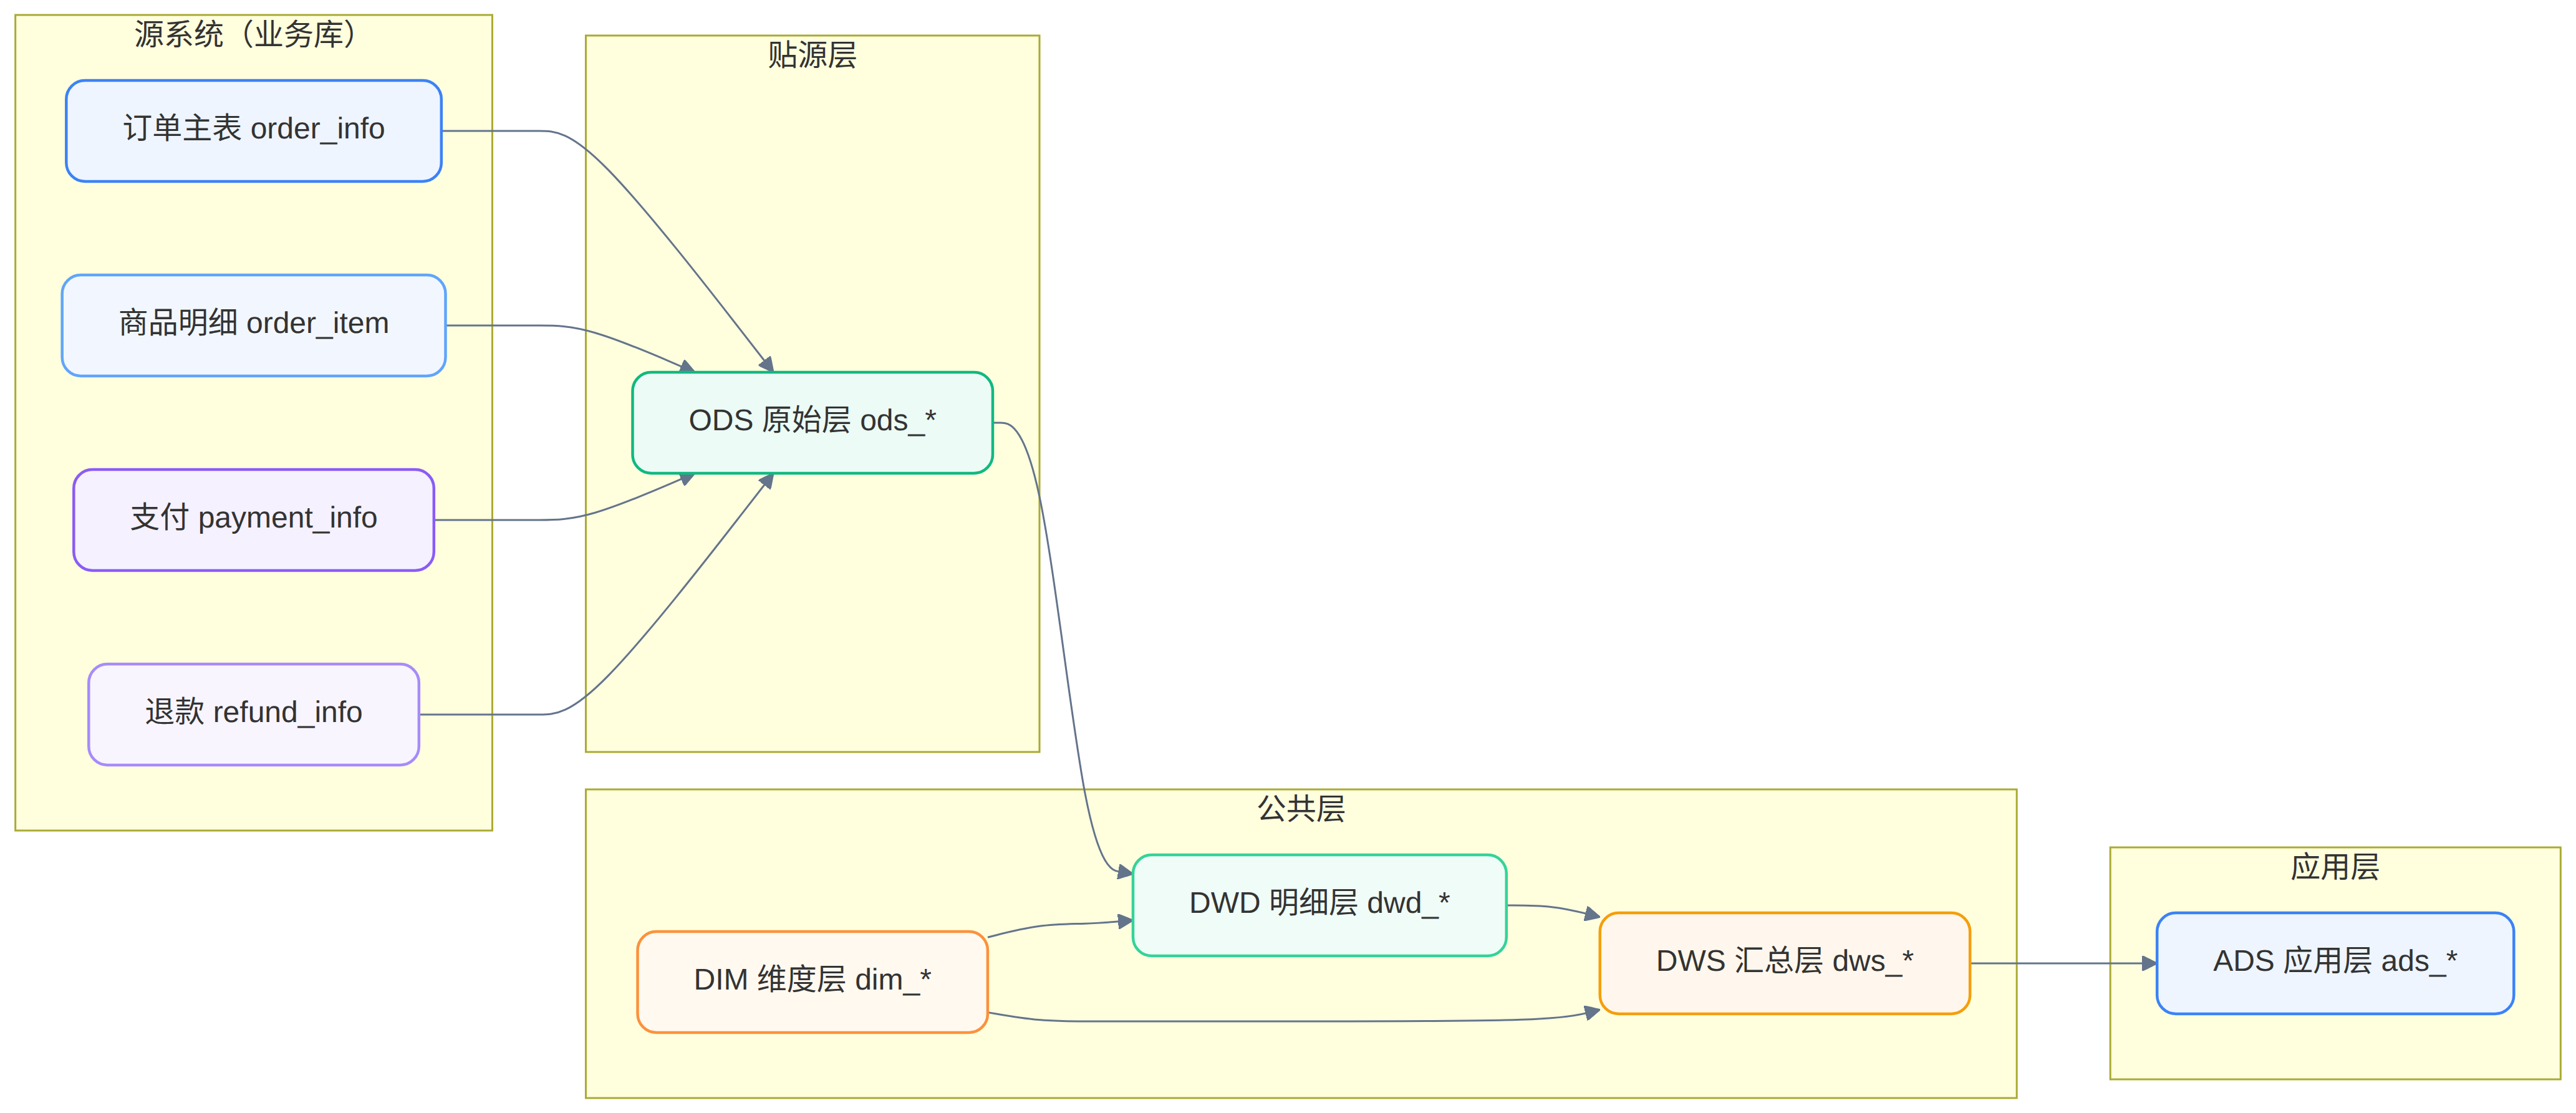
这张图最关键的地方不是层数,而是数据只朝一个方向走:贴源层进公共层,公共层进应用层。每道工序的输入、加工、输出都固定,出问题时才知道该去哪一层找。
第一道工序 ODS:把源数据原样保留
数据进数仓的第一站叫 ODS。这一层几乎不做业务加工,就是把源系统的数据原样接进来:订单主表 order_info 同步成 ods_order_info,商品明细 order_item 同步成 ods_order_item,支付 payment_info 同步成 ods_payment_info,字段还是原来的字段,只额外加两个过程字段:dt(哪天接进来的)和 etl_time(什么时间接进来的)。
为什么不在这里顺手清洗一下?因为 ODS 的任务是"别把真相弄丢"。源系统的数据可能被人改过、回补过历史。如果第一层就开始混入业务加工逻辑,等后面口径起了争议,或者源系统回补了历史数据,你就再也还原不出"当时的数据到底是什么"。所以要先稳稳保留原始数据,留下一个可以追溯、可以重算的起点。现代湖仓里的 Bronze 层也是这个思路:原始数据原样落盘,不在这一层做清洗和校验。
第二道工序 DWD:把明细整理到一条记录一个事件
ODS 里的数据还带着源系统的样子,字段可能有脏数据、类型不统一、同一件事被拆成好几张表。DWD 要做的,是把它们整理成可以稳定复用的业务事实:清洗脏数据、去重、统一字段类型、把订单和商品明细这些事件对齐。
但真正决定 DWD 质量的,不是写了多少行清洗逻辑,而是一个词:粒度。
粒度:一行到底代表什么
"订单表"这个说法其实很含糊,它至少可能对应三种完全不同的表:
- 一行代表一笔订单;
- 一行代表一条订单商品明细;
- 一行代表订单在某一天的状态快照。
三种表都能叫"订单表",但能回答的问题完全不同。一行一笔订单的表,能回答"今天有多少笔订单",却回答不了"某个 SKU 卖了多少件";要回答商品维度的问题,必须有一行一条商品明细的表。
Kimball 把这件事说得很透:事实表的粒度(grain),是"创建这条事实记录的那次业务测量事件"的业务定义,它由数据来源的物理现实决定,不是拍脑袋定的。他举过一个零售的例子:收银员扫一件商品,收银机"哔"地响一声,这一声"哔"就是粒度,一行事实记录对应一次扫描。反过来,如果先做一张"每个门店每月卖了多少钱"的汇总表,再想回答"哪件商品卖得好",就无从下手,因为汇总已经把商品这个维度丢掉了。
所以粒度要从最细、最原子的一层开始定。
一个订单两条商品,为什么会多出 120 元
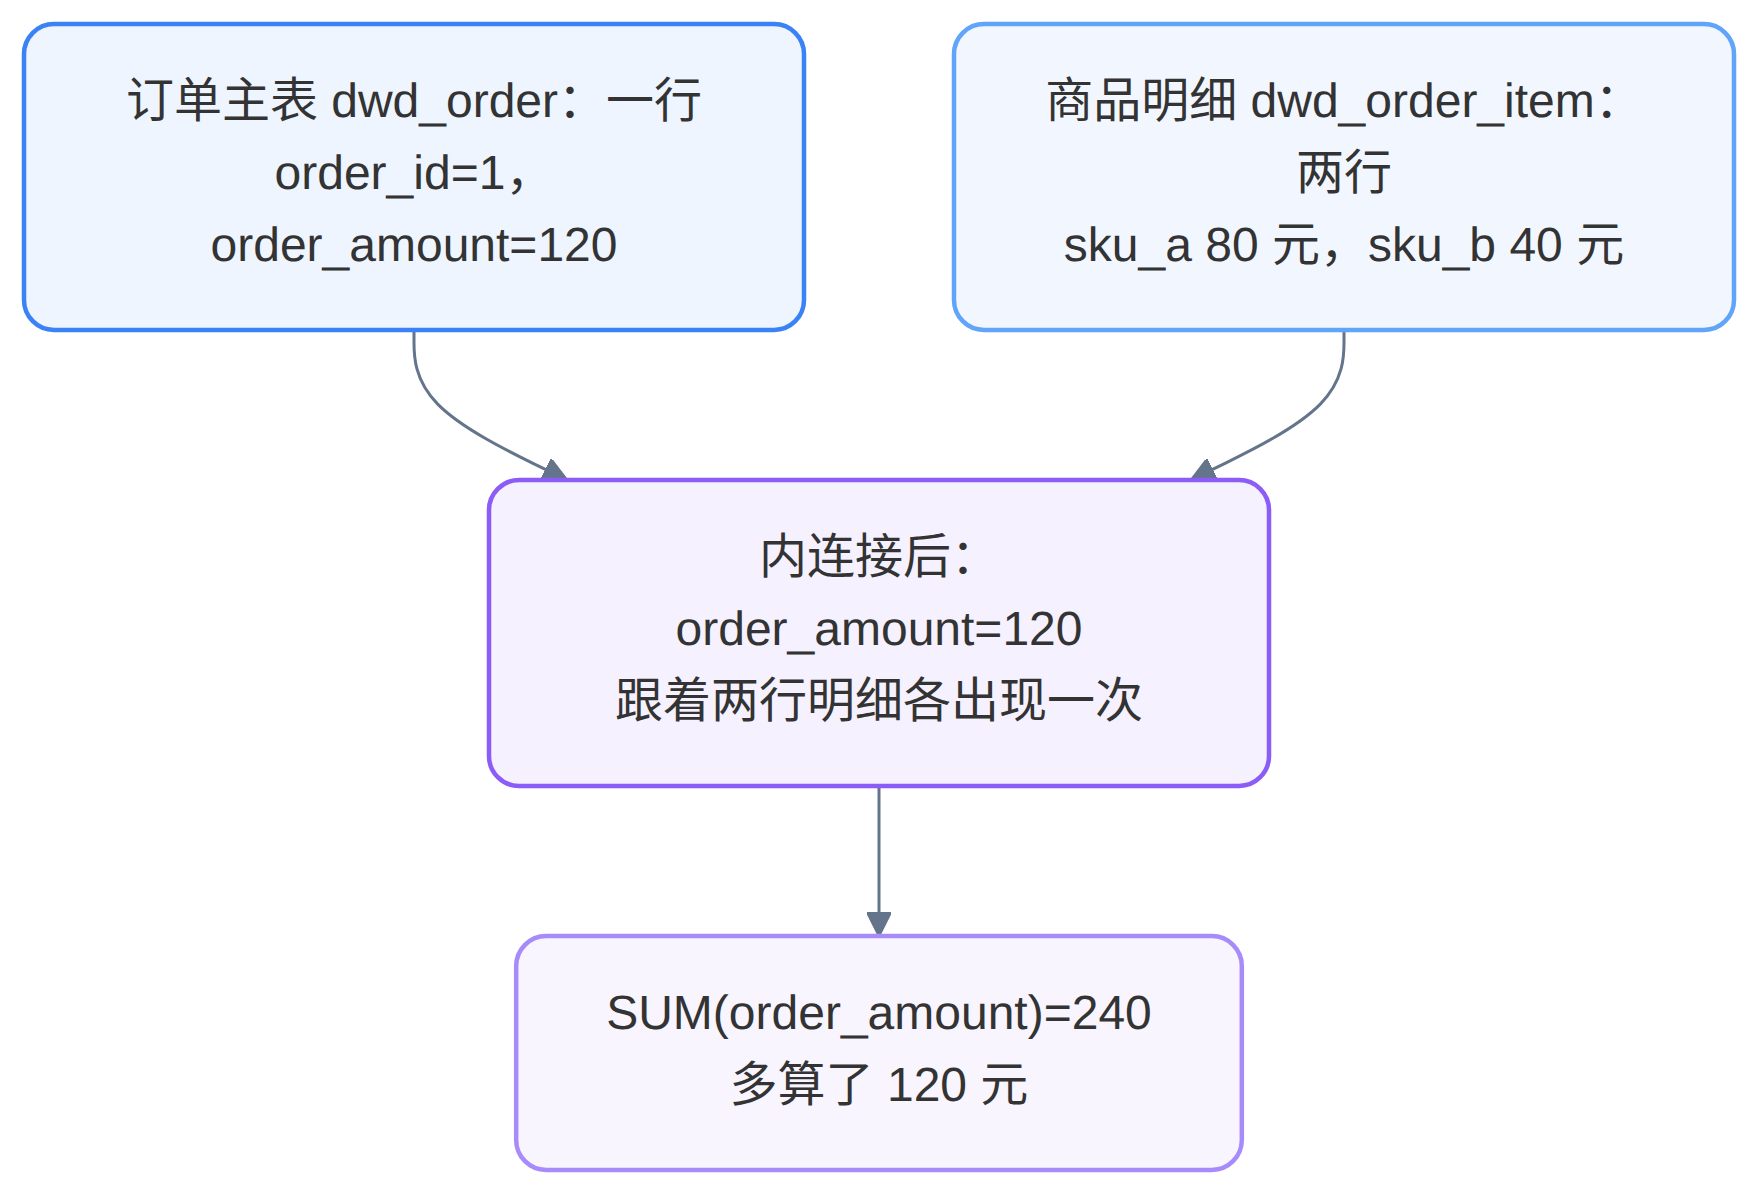
粒度定错,最直接的表现就是金额被重复累计。看一笔具体的订单:一笔订单 120 元,里面是两条商品明细,一件 80 元、一件 40 元。源表里,订单主表一行(120 元),商品明细表两行(80 元和 40 元)。
如果 DWD 把事实表做成"一行一笔订单",那么在它关联商品明细时,order_amount 的 120 会跟着两条明细各出现一次:
写成 SQL 就是这样:
SELECT
  o.order_id,
  o.order_amount,
  i.sku_id,
  i.item_amount
FROM dwd_order o
JOIN dwd_order_item i
ON o.order_id = i.order_id;
o.order_amount 的 120 会跟着两行明细各出现一次,于是 SUM(o.order_amount) 得到 240 元,而不是 120 元。这不是 SQL 写错了,是粒度选错了:把"订单级"和"明细级"两种不同的测量事件塞进了同一张事实表,也就是 Kimball 说的"混合粒度"。混合粒度几乎没法修复,只能靠查询端的小心翼翼去规避,而让使用方去纠正粒度问题,正是要避免的。
正确的做法是把 DWD 做成"一行一条订单商品明细",金额已经拆到明细行上:
SELECT
  order_id,
  order_item_id,
  sku_id,
  item_amount
FROM dwd_order_item_detail;
这样 120 元自然就是 80 加 40 两行,商品级的销量、销售额算得对,订单级的金额用 SUM 也能算回来。想让明细支持更多分析(下单件数、支付件数、退款件数、SKU 销售额、店铺成交额),把金额和数量落在商品明细这一行,就是最稳的起点。
贯穿始终的 DIM:让谁、什么、哪一天口径统一
明细和汇总里反复出现的"用户、商品、门店、日期",是分析时的维度。DIM 层要做的,是把这些维度各自定义成一份统一的标准,比如 dim_user、dim_shop、dim_sku、dim_date。
为什么不能每张表自己定义一套?因为一旦维度定义不统一,同一个指标就会被算出不同的结果。比如"门店属于哪个区域":A 报表按门店注册地归到华北,B 报表按仓库所在地归到华东,那么同一笔订单金额就会分别进入华北和华东两个合计里。问题不在 SQL,而在两个报表引用的是两套不同的门店归属定义。
DIM 层就是把这些定义收拢到一处,让明细层和汇总层都引用同一份维度,口径才算真正统一。
第三道工序 DWS:把公共口径沉淀成汇总
明细已经统一了,为什么还要再来一层汇总?因为很多指标是多个报表都要用的:门店的日订单数、日支付金额,运营看板要,财务对账要,活动复盘也要。如果没有汇总层,每一张报表都得自己从明细里按日期、门店 GROUP BY 再 SUM 一遍,既重复算,口径也容易出现差异。
DWS 干的就是这件"把公共口径沉淀下来"的事,比如:
SELECT dt, shop_id,
       COUNT(DISTINCT order_id) AS order_cnt,
       SUM(pay_amount)         AS pay_amount
FROM dwd_order_item_detail
WHERE dt = '2026-10-24'
GROUP BY dt, shop_id;
这张 dws_shop_sales_day 表,主键是"日期 + 门店",指标是订单数、支付金额。上游各张报表直接读它,不用再各自从明细算一遍。
但 DWS 也是最容易被用坏的一层:还没验证复用价值就先建一堆汇总表、一个部门搞一个自己的 DWS 版本、口径都没稳定就提前做很深的预聚合,最后汇总层变成没人敢删、也没人敢改的中间表垃圾场。所以只有真正高复用、口径稳定的指标才值得进 DWS。
第四道工序 ADS:面向业务做最后一跳
最贴近业务的一层是 ADS,它面向具体的报表、看板、接口、标签,比如运营看板要的 ads_operation_dashboard_day,里面有支付订单数、GMV、客单价、新客支付人数这些指标。
ADS 最大的特点是离业务最近,也就最容易变。正因为容易变,它反而不该承载公共逻辑:公共清洗放在 DWD,公共汇总放在 DWS,ADS 只做贴近业务场景的最后一跳组装。这样上面的需求再怎么变,底层的公共资产也不会被拖着反复改。
守不住边界,分层就只是空架子
名字都叫 ODS、DWD、DWS、ADS,为什么有的数仓还是一团乱?因为分的是名字,不是职责。真正决定分层成败的,是四条边界有没有守住:
- 原始层要可追溯:ODS 保留原始真相,源系统回补历史时能还原、能重算;
- 明细层要粒度清晰:DWD 声明并守住"一行一个业务事件",不混粒度;
- 公共层要口径统一:DWS 只沉淀高复用、能回溯到明细的指标,维度用 DIM 统一;
- 应用层要只做最后一跳:ADS 不做公共加工,不越层直接读 ODS。
这四条里最容易塌的是最后一条:应用层为了赶需求,直接从 ODS 或一堆杂乱中间表取数,绕开公共规范。久而久之,整个数仓名义上有分层,实际已经失控。
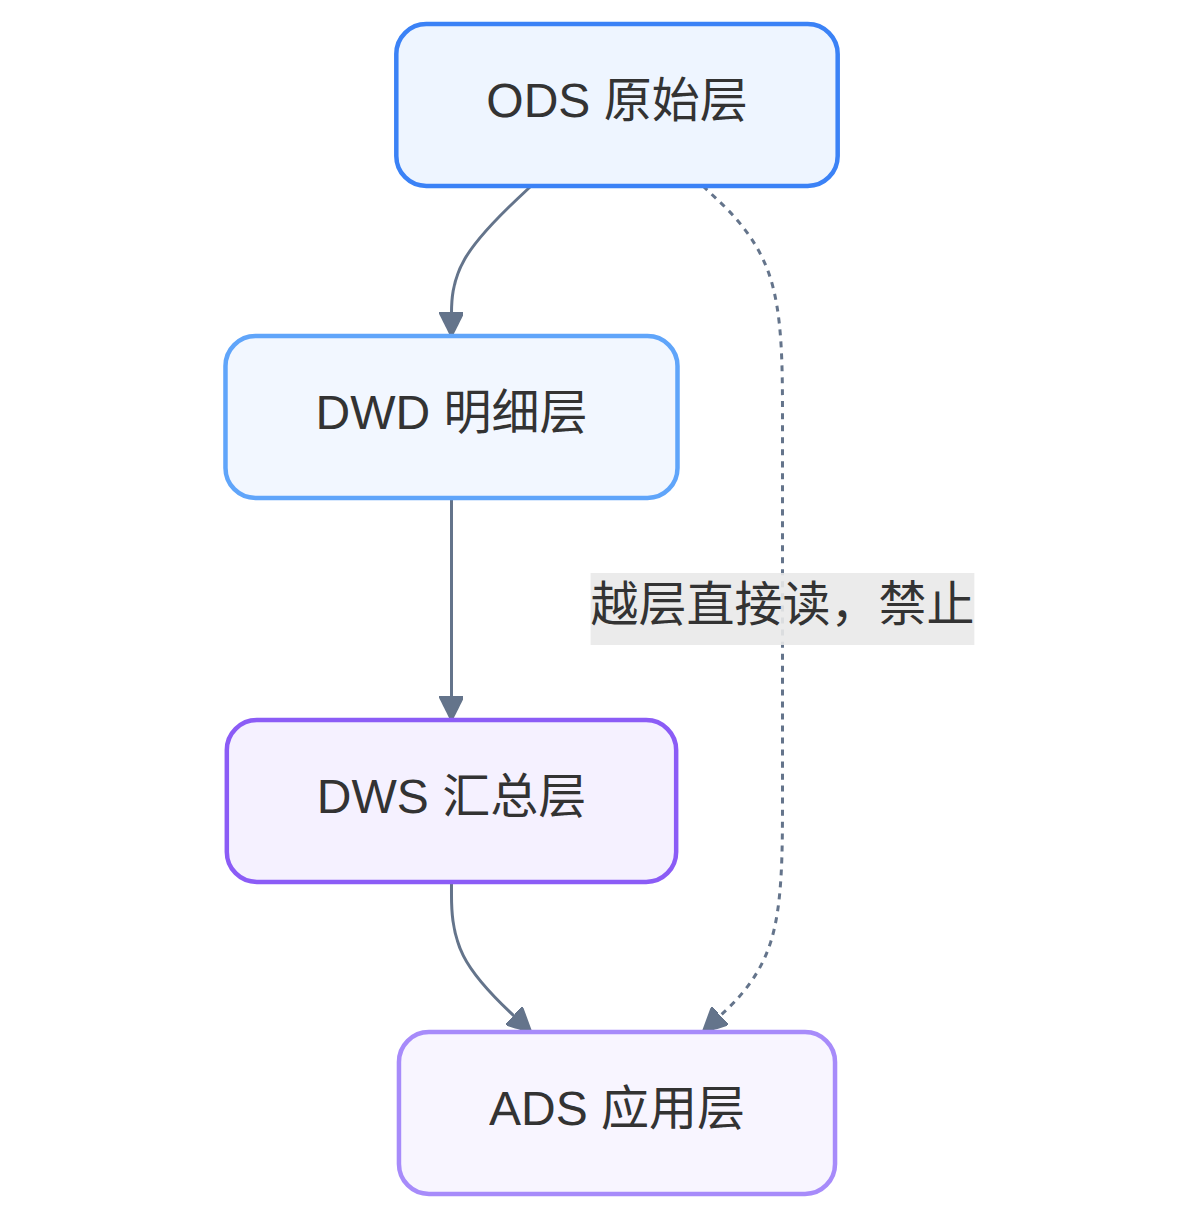
回到最开始的问题:到底分几层?这通常是阶段问题,不是对错问题。团队小、分析主题少、先把链路跑通的时候,压成"原始层 + 明细公共层 + 消费层"三层也够;等到多个团队共用同一批数据、指标口径开始打架、看板和接口越来越多,再把 DWS 显式拆出来。层数可以按需增减,四条边界不能丢。
评论