
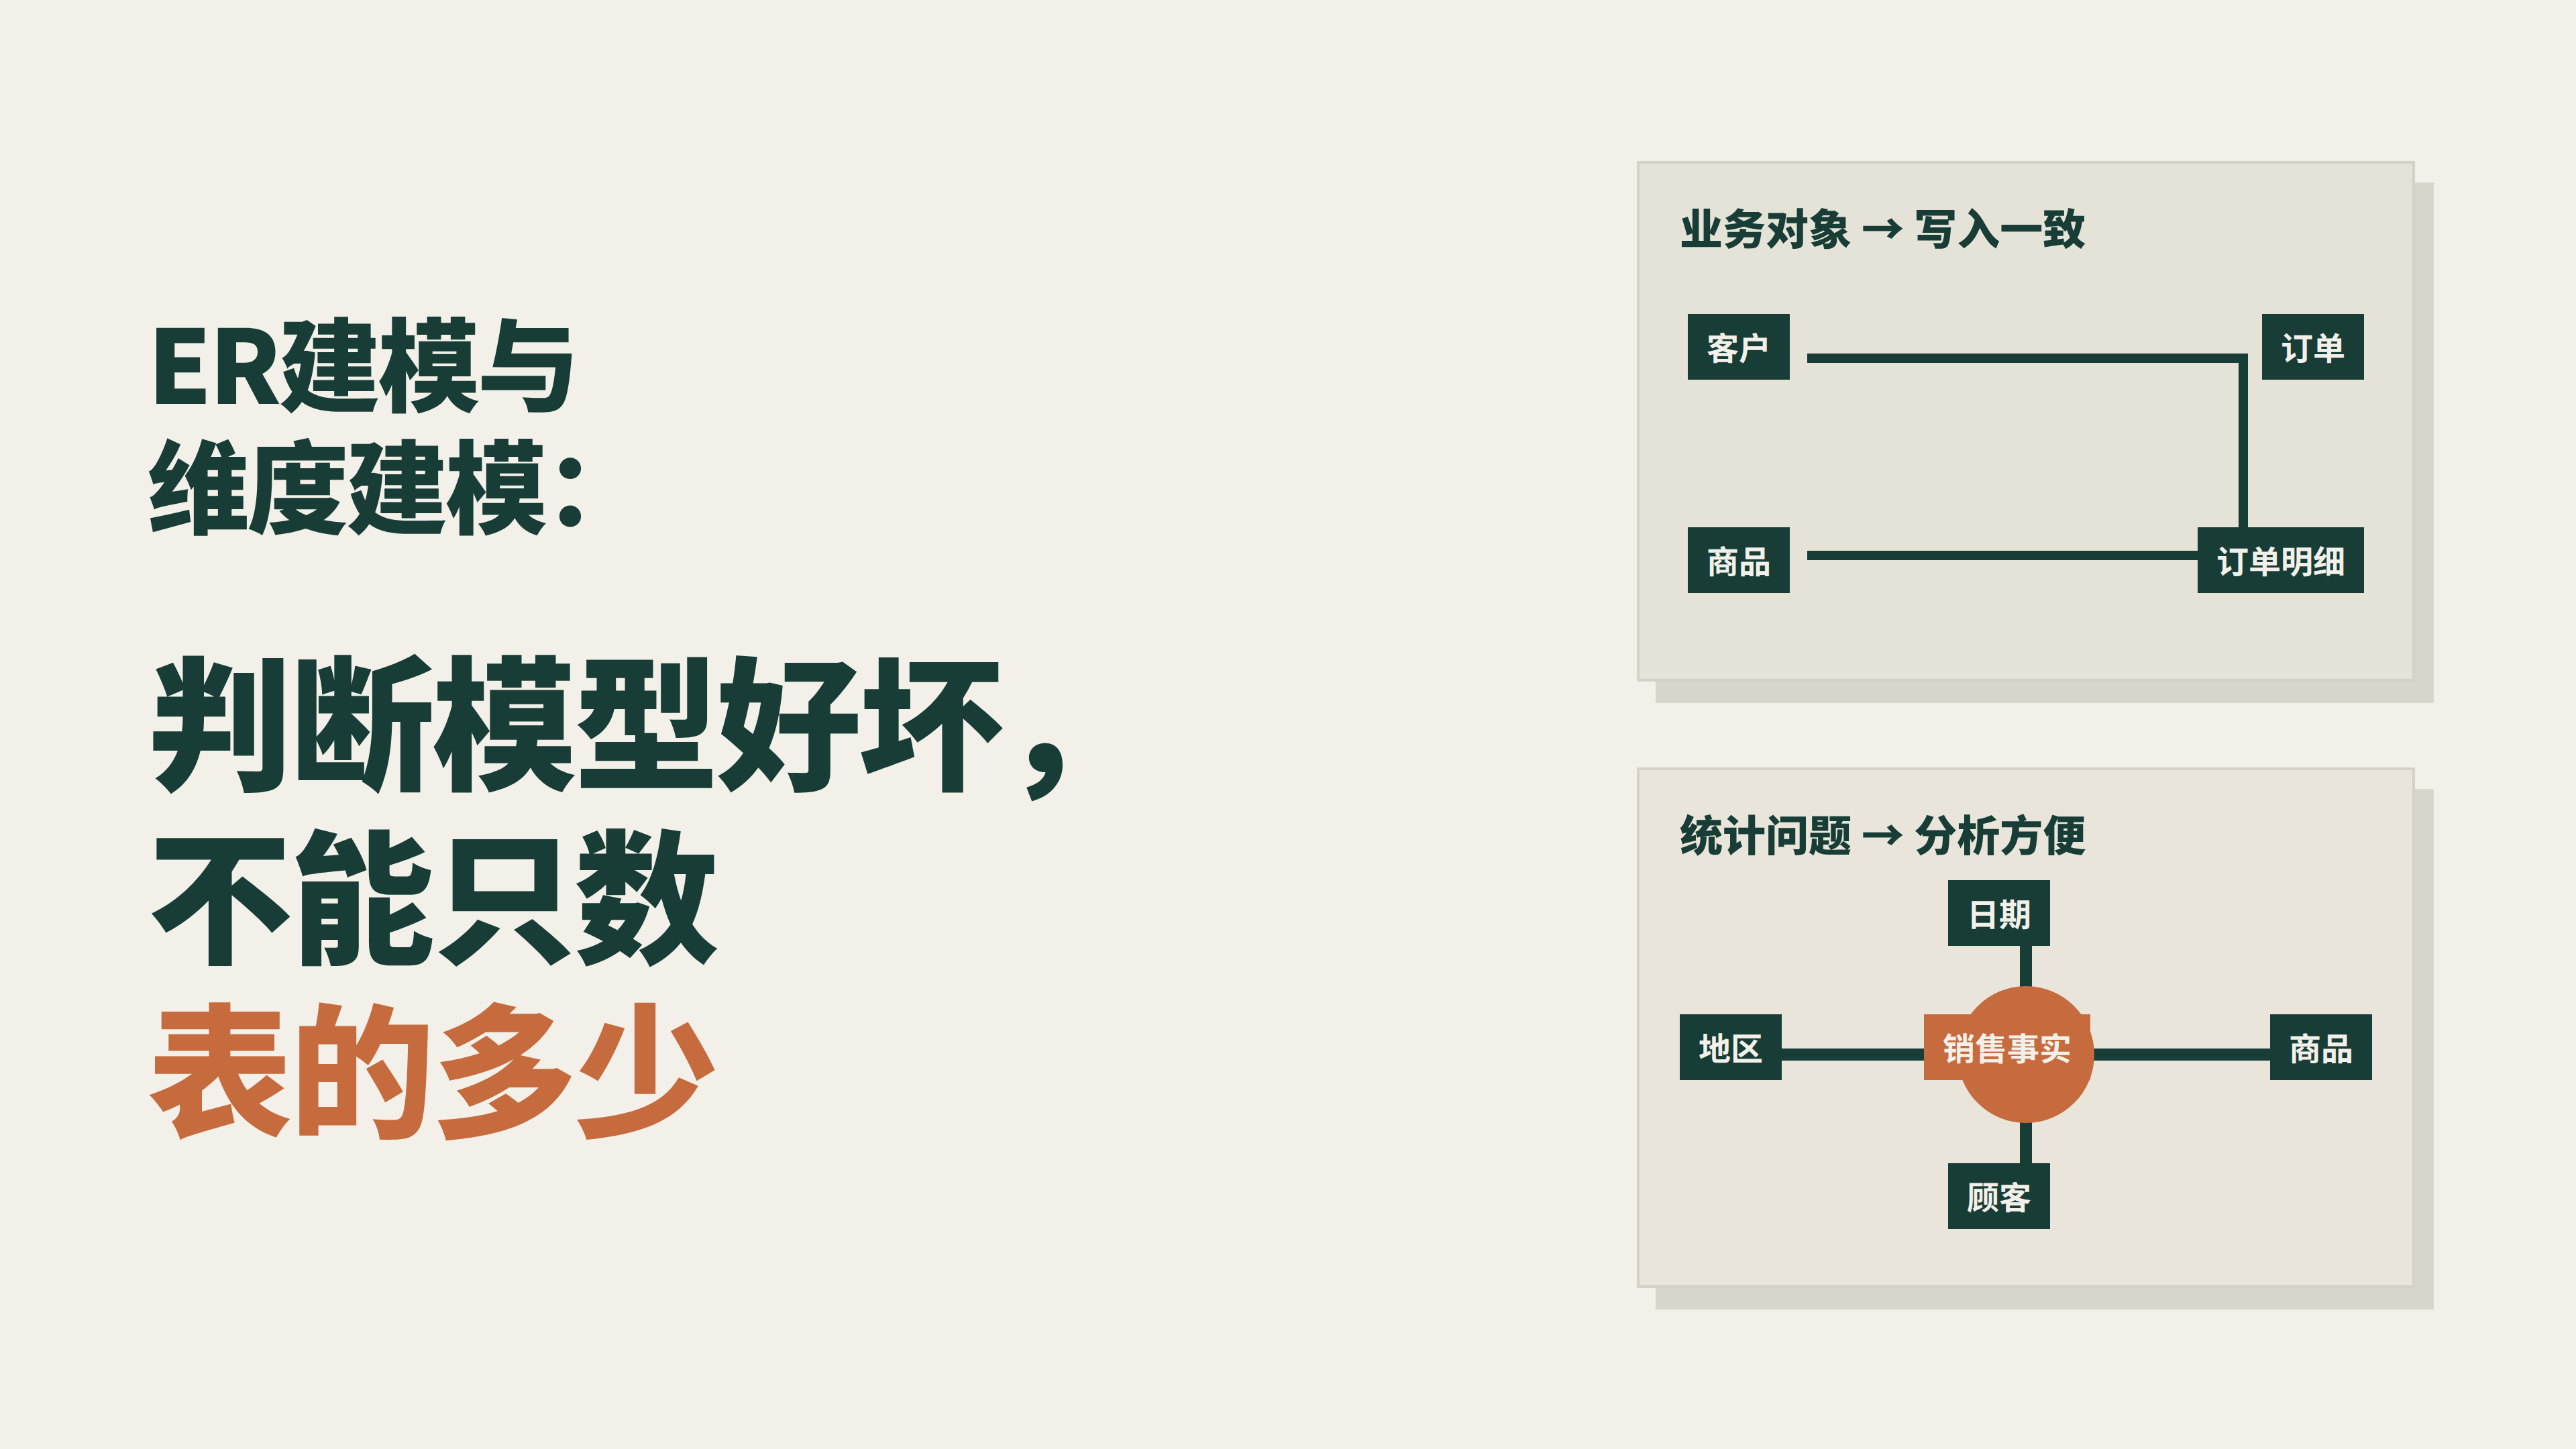
ER建模与维度建模:判断模型好坏,不能只数表的多少
同一份订单,在交易系统里是好几张互相连接的窄表,在分析系统里却是一张中心事实表,边上还围着一圈小表。前者侧重按业务对象和字段依赖组织数据,后者侧重按统计粒度和分析角度组织数据。这两种建模方式背后是两种数据组织思想:一种叫 ER 建模加规范化,先照业务的样子把对象和关系画清楚,再决定表怎么建;另一种叫维度建模,围绕"想按什么角度、算什么数字"来组织数据。它们不是谁好谁坏,而是各管一件事。
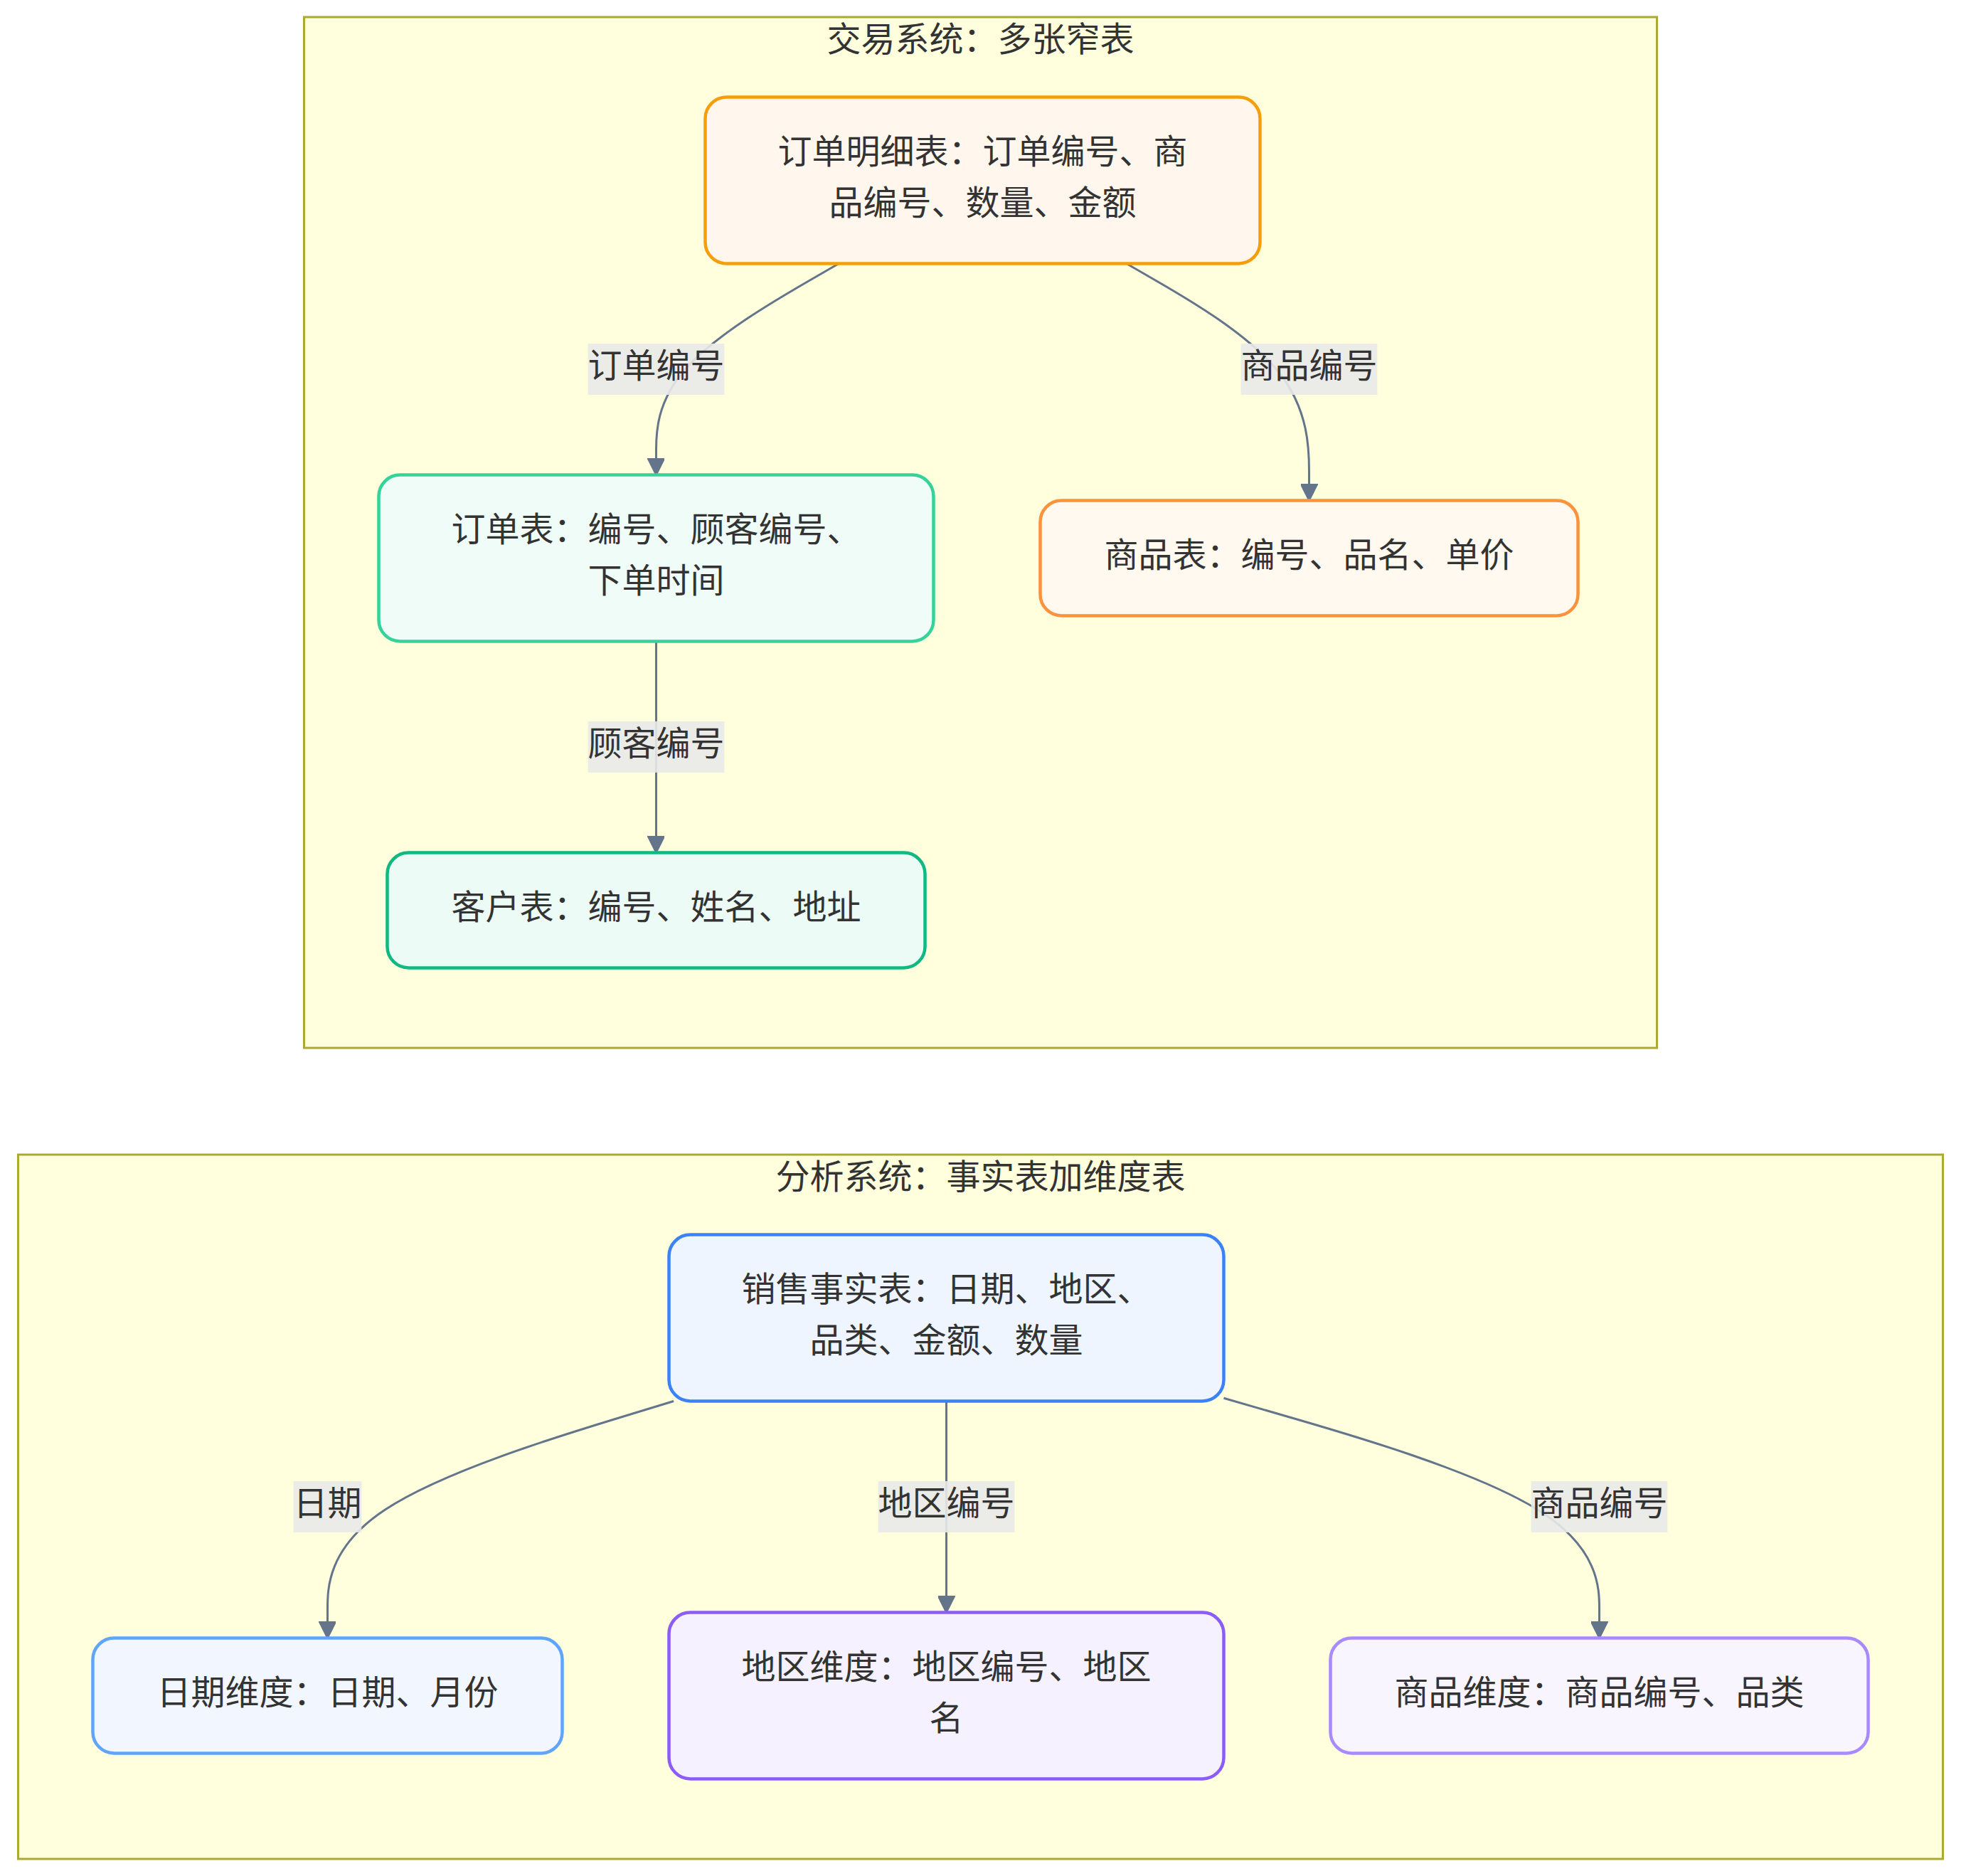
同一个订单,交易库和分析库各存各的
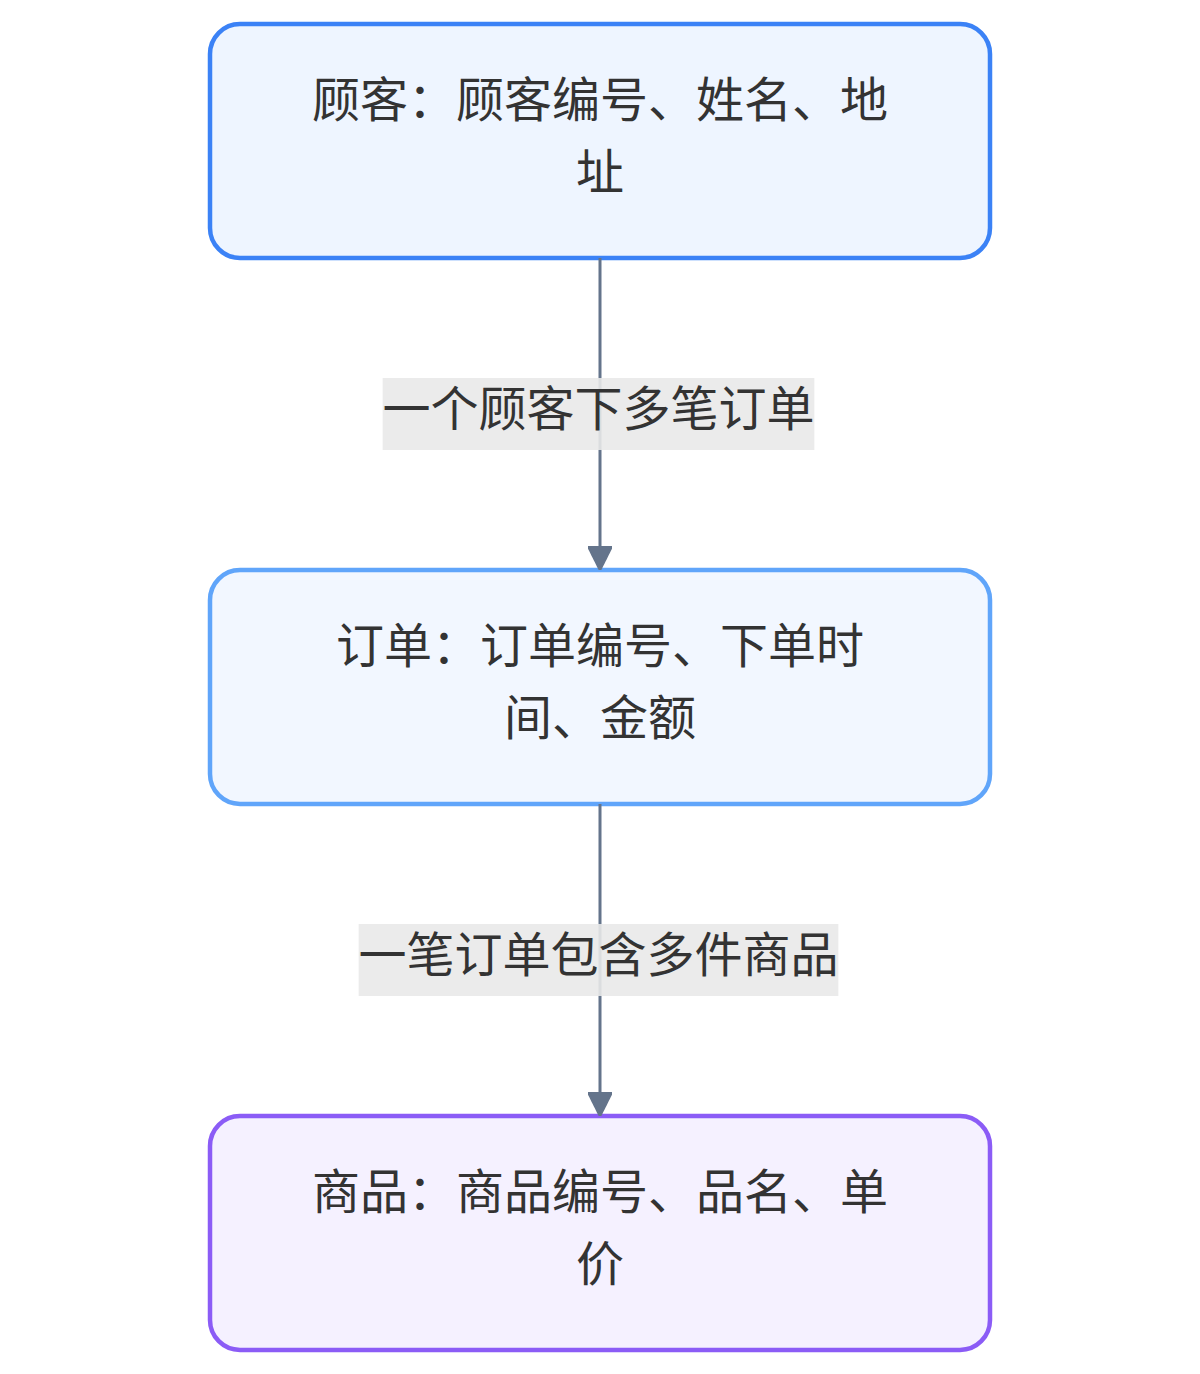
一家网店,顾客下单,每张订单里有几样商品。业务里能识别出来的对象很清楚:顾客、商品、订单,还有顾客的收货地址。
交易系统里,这些信息一般不会塞进一张表。顾客信息在客户表,订单在订单表,商品在商品表,订单表里只放顾客编号,订单明细表里放商品编号,用编号把几张表连起来。记一笔订单,可能要同时往客户表、订单表、订单明细表写几行。这么做是为了写入不出错:顾客的姓名和地址只存一处,改也只改一处,不会出现同一家店这张订单叫张三、那张订单叫张叁的情况。
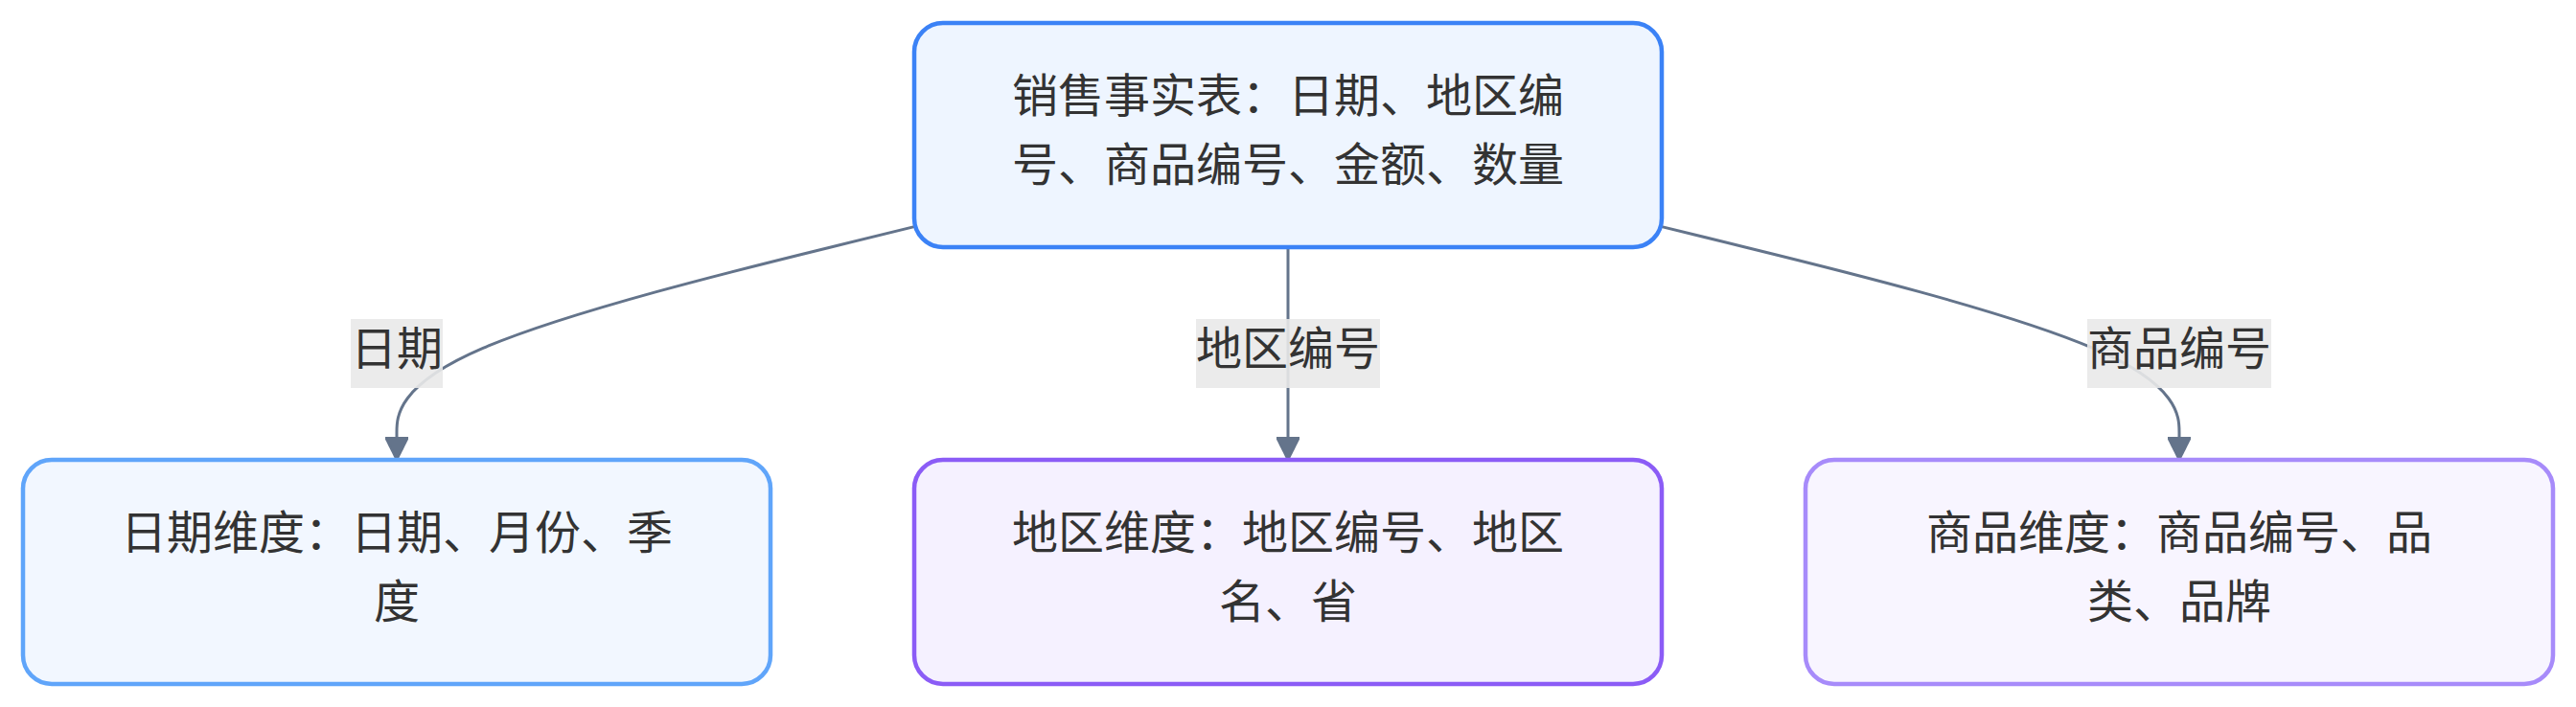
分析系统则围绕统计问题来组织数据。为了回答"上个月各地区、各品类卖了多少",把销售额、销售数量集中放进一张事实表,把地区、品类、顾客这些描述信息放进旁边的维度表。事实表一行就是一笔订单明细,每行都带着日期、地区编号和商品编号;算某个地区的销售额,就把事实表和地区维度表连起来,按地区分组求和。
同一个订单,两套摆法。一套围着"怎么把每笔业务又稳又不出错地写进去",一套围着"怎么方便地把历史数据按各种角度算出来"。这就是两种建模思想的出发点。
ER建模:先照业务的样子,把对象和关系画出来
ER 里的 E 是实体(Entity),R 是联系(Relationship)。实体就是业务里要记录的一类东西:顾客、商品、订单。实体有属性,也就是描述它的信息:顾客有姓名、电话、地址,订单有下单时间、金额。实体之间还有联系:一个顾客下多张订单,一张订单里有多件商品,一种商品也能出现在多张订单里。
ER 建模先做一件事:把这些对象和关系照业务里的样子画出来,再照着这张图建关系表。实体画成一个框,属性列在框里,联系画成一条线。这张图叫 ER 图。
落到关系表上,规则大致是:一个实体变成一张表,实体的属性变成表的列,实体之间的联系变成表之间的键。顾客实体变成客户表,姓名、电话、地址是列;"一个顾客下多张订单"这条联系,落到订单表里就是一个顾客编号列,用它指向客户表,这样两张表就通过键连起来了。商品和订单是多对多,一张订单有多件商品,一种商品也能进多张订单,所以要加一张订单明细表,把"哪张订单里买了哪个商品、买了几件、花了多少钱"单独记下来。
规范化:依据字段依赖拆表,不是见字段就拆
把实体画成表之后,还有一个问题:一张表里的字段放得对不对。规范化的作用就在这里,它依据的是字段之间的依赖关系,目标是把不必要的重复信息拆出去。
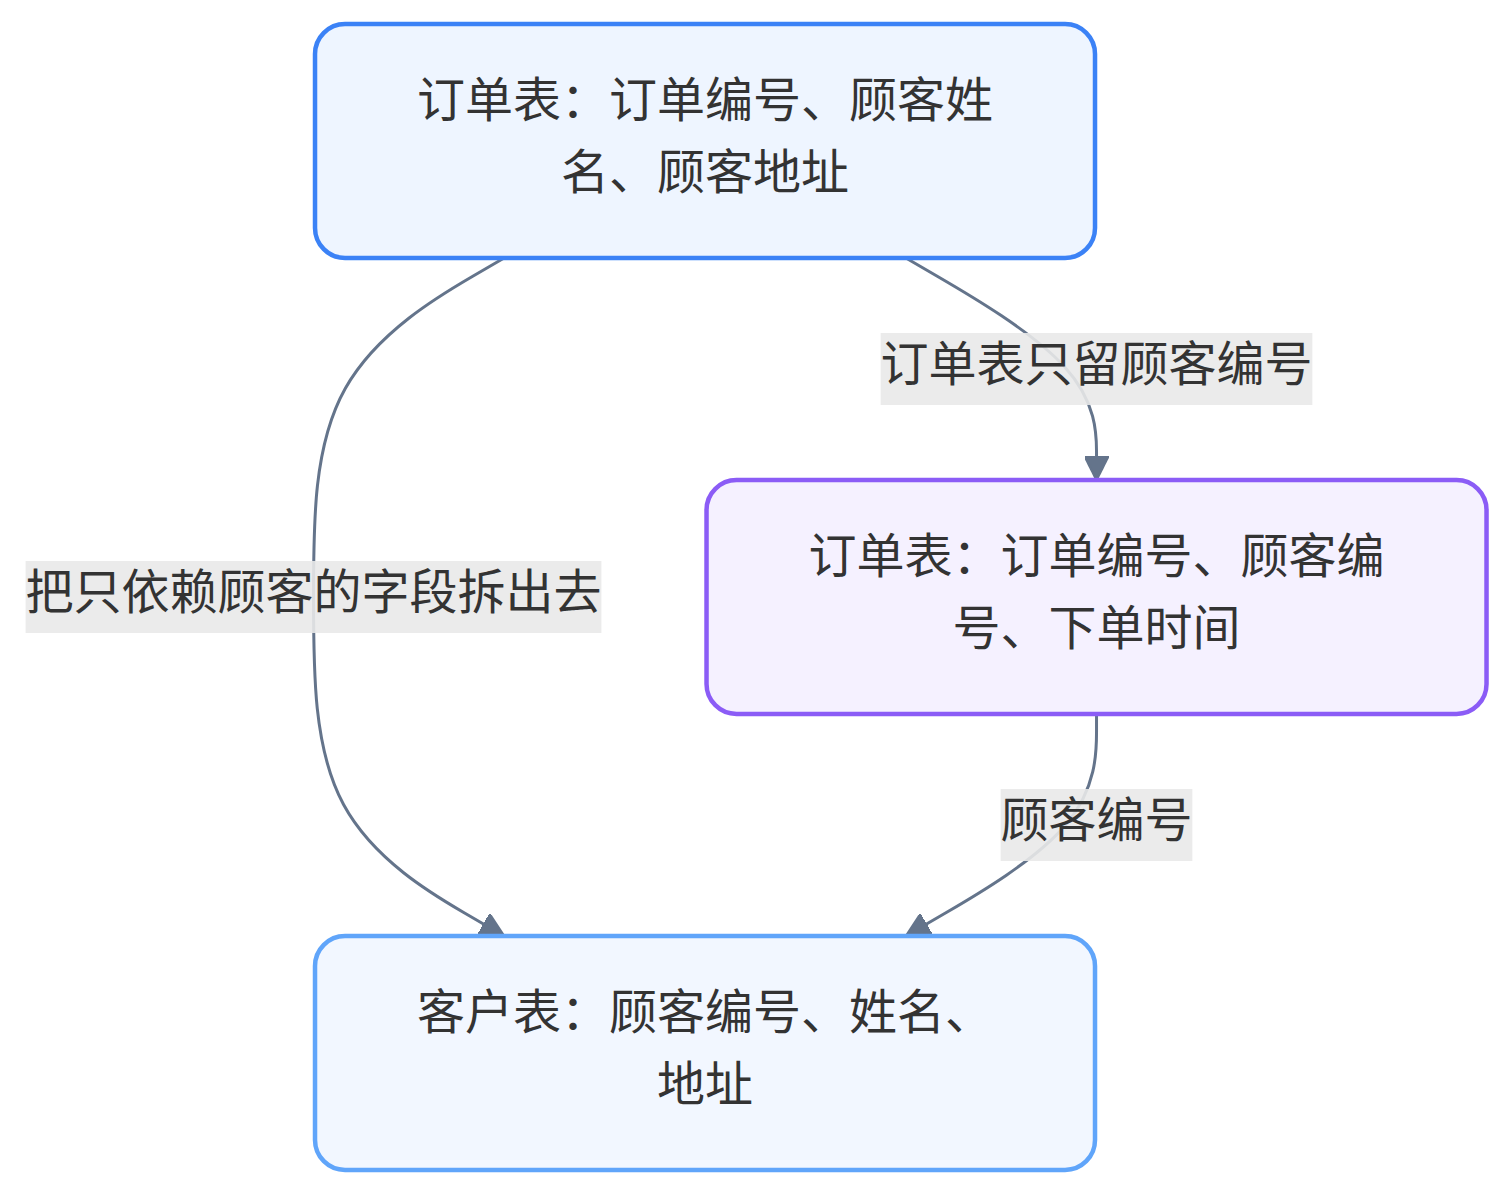
看一个反例。如果订单表里每行都重复写上顾客姓名和地址:
| 订单编号 | 顾客姓名 | 顾客地址 | 下单时间 |
|---|---|---|---|
| 1001 | 张三 | 北京市朝阳区 | 3月1日 |
| 1002 | 张三 | 北京市朝阳区 | 3月5日 |
问题来了。张三搬家,地址从朝阳区改成海淀区,就得把张三所有订单行都改一遍,改漏一行,同一个顾客就出现了两个地址。这叫更新异常。反过来,一个新顾客还没下过单,地址就没地方存,因为订单表里一行就是一单,没有订单就没有行。这叫插入异常。如果把张三的订单都删掉,张三的地址也跟着没了。这叫删除异常。
如果这里记录的是顾客资料中的地址,那么地址由顾客编号确定,订单编号则通过顾客编号间接确定地址。把这样的地址重复存到每笔订单里,就会产生前面说的异常。规范化的做法,就是把顾客姓名、地址这些描述顾客的字段放到客户表里,订单表通过顾客编号关联客户表。这样地址只存一处,改一处就行,新顾客没下单也能先登记,删掉订单也不会丢掉顾客。
但规范化不是见字段就拆。金额是跟着订单明细走的:如果同一商品在一张订单里只对应一条明细,金额就由订单编号加商品编号共同确定,应留在订单明细表里。关键不是字段有没有依赖关系,而是它描述的是当前这条记录,还是另一个对象;也不是字段越多越要拆,或表越少越好。
维度建模:围绕要回答的问题,把观察角度和数字分开
分析系统面对的问题不一样:它不在乎"下这单要写几张表",在乎的是"按地区、按月份、按品类,各卖了多少"。维度建模就围绕这种问题来摆数据。
它把数据分成两类。一类是数字,也就是要统计的度量,比如销售金额、销售数量,放在事实表里。一类是描述,也就是观察的角度,比如地区名、品类名、月份,放在维度表里。事实表里的每一行对应一个确定的粒度,一行代表什么要先说清楚:如果一行是一笔订单明细,那么金额就是这一行那件商品卖出的钱;如果一行是一张订单,金额就是整张订单的钱。粒度变了,一行代表的意思就变了。
观察角度靠维度表提供,统计数字靠事实表提供,两边各司其职。按地区统计销售额,就是把事实表和地区维度表关联起来,按地区名分组,把金额加起来:
SELECT
  d.地区名,
  SUM(f.金额) AS 销售额
FROM 销售事实表 f
left join 地区维度表 d
ON f.地区编号 = d.地区编号
GROUP BY d.地区名;
维度表里放的是描述属性,可以适当地铺开。例如,在地区维度中同时存放地区名和省名,事实表通过地区编号关联它后,就能直接按这些属性筛选和分组。这正是分析模型和交易模型在处理同一信息时的不同之处。
同样一份地址信息,两种模型怎么处理
把"地址"这个具体信息拎出来,能看清两种模型的差别。
交易系统里,这里仍以顾客资料中的当前地址为例。客户表里存着地址,订单表通过顾客编号关联客户表。张三搬家了,改一次客户表,通过顾客编号查询到最新地址,并保持全局一致。但是有个问题,以后都只能查到最新地址,无法找到下单时的收货地址。
分析系统里,关注的是地址中的地区信息,要用它来筛选和分组。销售事实表里不放地区名,放地区编号,旁边一张地区维度表放着"北京市""海淀区"这些现成的名字。要按地区统计,直接连维度表就能用地区名分组。这里可以按需补充一些属性说明,比如同时存地区名和省名,查询起来更顺手。
两种模型都通过编号关联描述信息,差别不在于处理方式相反:交易模型把顾客当前地址放在客户表里,是为了改一处处处一致;分析模型围绕地区组织描述属性,是为了筛选分组方便。有控制的冗余在分析这边是被允许的,但仍需维护数据一致性:地区维度编号变更时,事实表仍要能正确关联。
表多表少不是标准,看它服务什么问题
拆不是好,合也不是坏。规范化和维度建模回答的是两个不同的问题,判断标准也应该是各自的问题:交易模型要写入不出错、保持数据一致、避免更新异常;分析模型要筛选直观、聚合方便、口径清楚。
而且两者常常在同一条数据链路里分工。交易系统用规范化把业务数据存好,之后要拿数据做分析时,再按维度建模的方式,把顾客、地区、品类整理成维度表,把要统计的度量整理成事实表。前一段保证写入一致,后一段保证查询方便。
所以判断一个模型好不好,不是数它表多还是表少,而是看它服务什么用途:把一份信息该拆的拆出去,该补的属性补全,才是在正确地组织数据。冗余不是坏事,失控的冗余才是。
评论