Hudi、Iceberg、Paimon 解决的从来不是存储,而是给数据湖加一层元数据
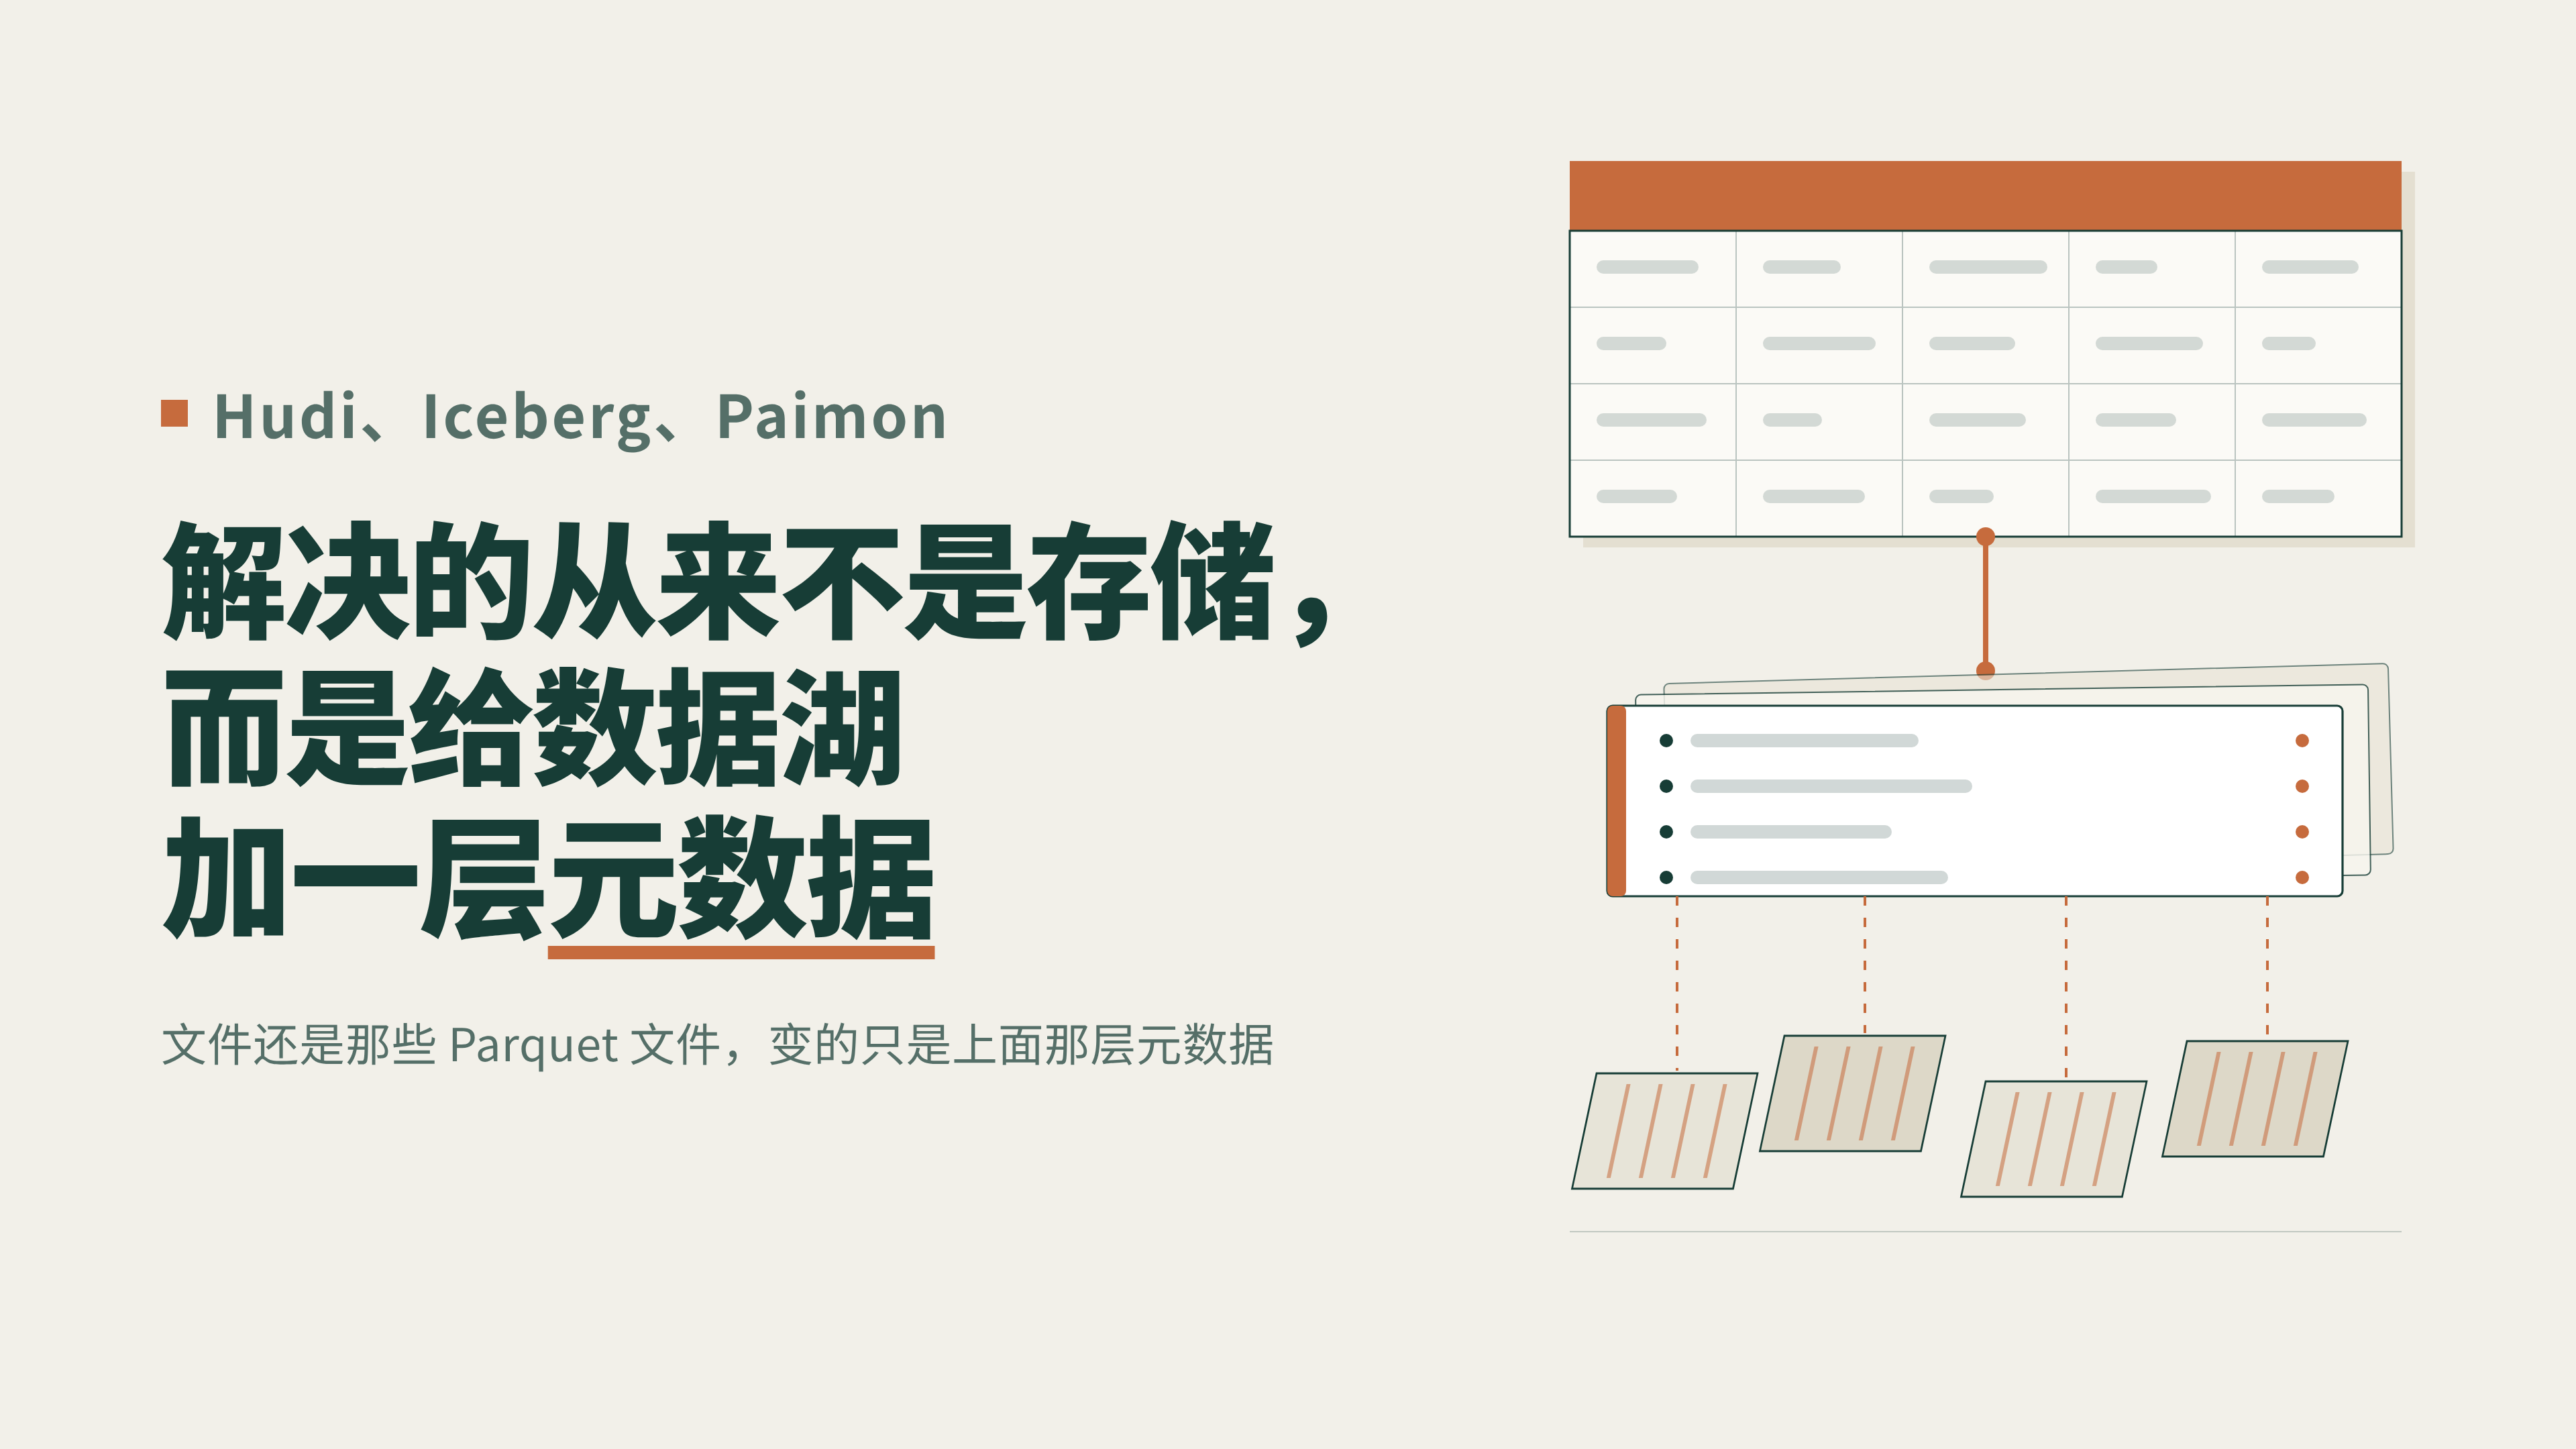
在对象存储上堆几千个 Parquet 文件,数据湖就算建好了吗?一旦要把它当仓库用,连“改一条订单的状态”都会很麻烦:Parquet 是列式文件,不能原地改一行,得把整个文件甚至一整个分区的文件读出来、改完再写回去,中途还得小心不能让正在跑的报表读到写了一半的数据。Hudi、Iceberg、Paimon 这些开放表格式要解决的核心问题就是这个。它们的共同答案不是发明新的存储格式,而是在数据文件之上加一层元数据,记录“表里有哪些文件、每次操作增删了哪些文件、现在处于哪个版本”。再用这层元数据把事务、改表结构、回到历史版本这些数据库才有的能力补到数据湖上。
数据湖为什么“便宜却改不动”
先把三个名词摆清楚。数据湖,本质是把各种原始数据直接堆在对象存储上,存成 Parquet、ORC、Avro 这类文件。好处是便宜、开放、什么格式都能放,坏处是它只是一堆文件,没有“表”这个概念,也没有谁能保证这批文件前后一致。
数据仓库就不一样了。它把数据按主题组织成一张张表,查询引擎里维护着 schema、统计信息,写入要么成功要么回滚,更新数据是系统原生支持的操作。代价是它通常要一个封闭的、专用的系统,数据往往是被清洗后复制进来的一份,贵,也不够开放。
湖仓一体(Lakehouse)希望兼顾两边:数据继续留在开放的对象存储上,但上面要有一层机制,让这批文件表现得像仓库里的表一样,能事务性地更新、能改结构、能查历史。这一层机制,就是开放表格式。它不是存储格式本身,Parquet 依然是 Parquet,它只是告诉你“这一堆 Parquet 文件合起来是一张什么表”。
开放表格式:在一堆数据文件上再加一层元数据
表格式和存储格式是两个概念。存储格式(Parquet、ORC、Avro)管的是“一行数据在文件里怎么编码、怎么压缩”;表格式(Iceberg、Hudi、Paimon、Delta Lake)管的是“一张表由哪些文件组成、这些文件怎么分组、每次写入让表变成了什么新状态”。表格式管理的内容几乎全是元数据,真正的数据文件还是那些 Parquet。
以 Iceberg 为例,一张表的元数据是一棵小树。最顶层是一个 metadata.json,它指向当前的表状态;往下是 manifest list,列出组成当前快照的各个 manifest 文件;每个 manifest 再指向一批实际的数据文件,并记录每个文件的记录数、各列取值上下界这类统计信息。数据文件本身一个字节都不用动,表的历史就藏在 metadata.json 的一层层指针里。
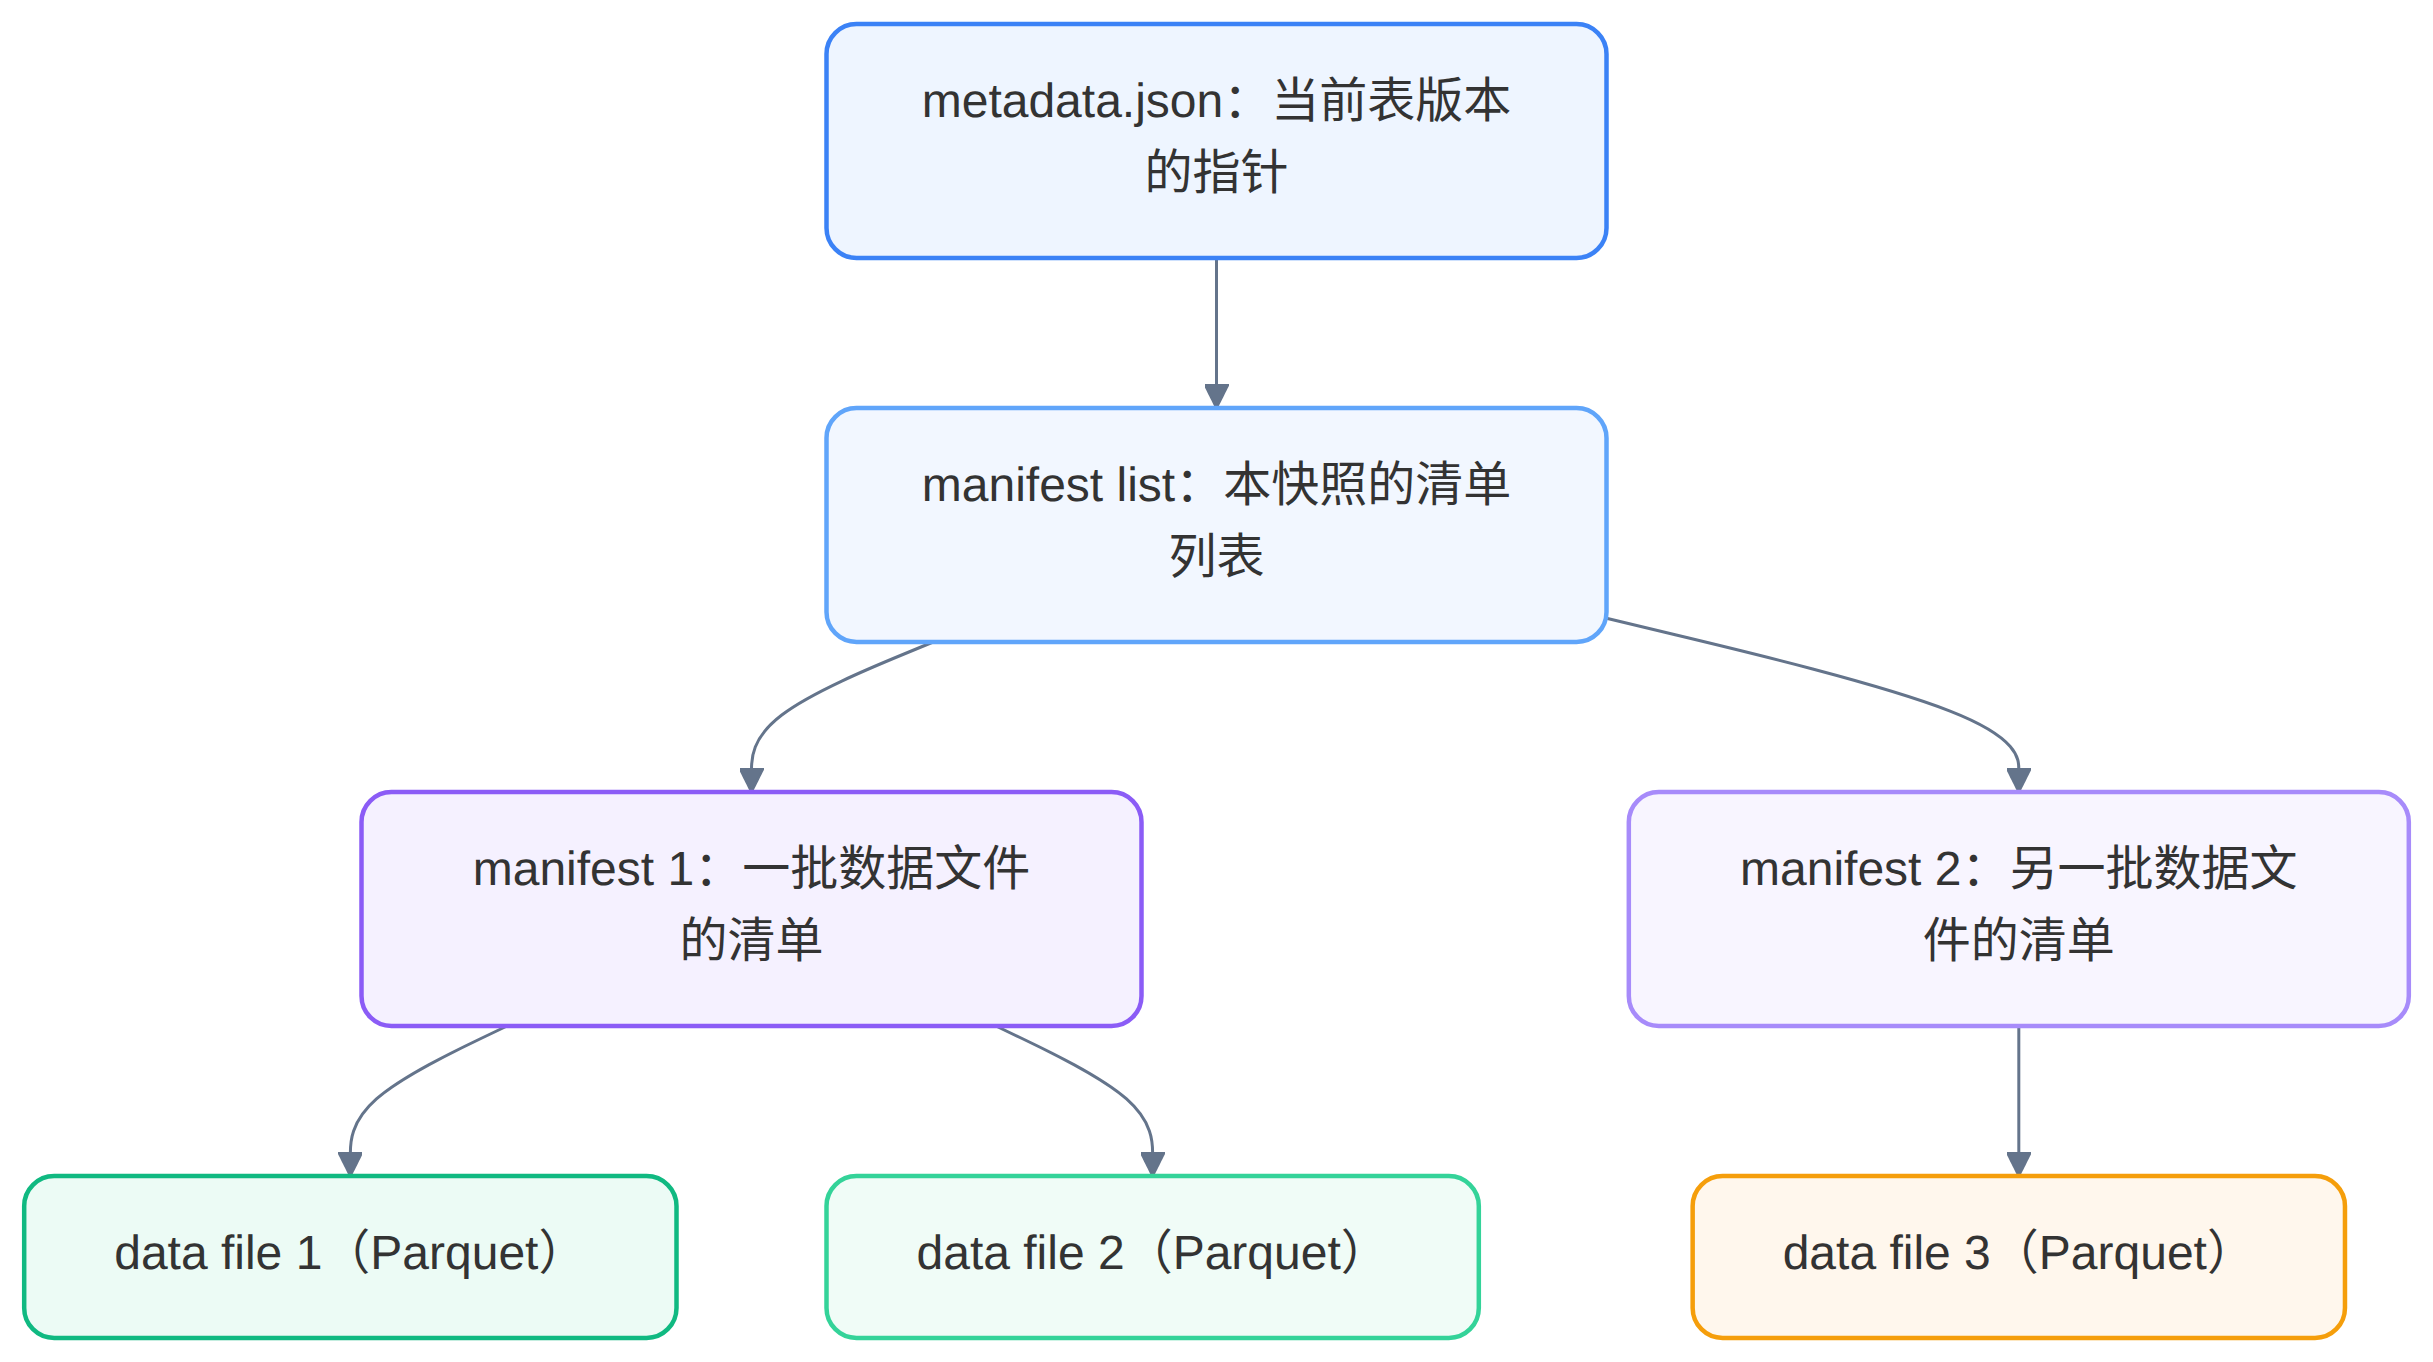
这张图可以这样理解:文件堆像一本没有目录的书,你只能一页页翻才知道里面有什么;元数据层就是补上的目录和页码,让“这张表现在有哪些文件”变成一条可以随时查、可以版本化的记录。
这一层元数据,换来了三件数据库才有的能力
元数据层具体换到三样东西:原子事务、Schema 演进、时间旅行。它们背后是同一个机制:把表的状态抽象成可提交、可回退、可回溯的版本。
原子事务:要么全成功,要么像没发生过
写文件最怕写一半失败。传统做法是覆盖原文件,写到一半进程挂了,表里就多了一堆半成品文件,谁也说不清哪些是新的、哪些是旧的。表格式的做法是“先写新文件,最后才换指针”:Iceberg 写入时先写新的数据文件和 manifest,全部就绪后,最后一步原子地把 metadata.json 切换到指向新的快照。读方要么读到旧的 metadata.json(旧快照),要么读到新的(新快照),永远不会读到中间态。Hudi 的思路类似,只是把提交记录放进一条 timeline(时间线),每次写入都往 timeline 上追加一个 commit 动作。因为“换指针”这一步是原子的,整批写入就跟着有了原子性。
Schema 演进:改表结构不用重写数据
在文件堆上给表加一列,几乎等于要把所有文件读出来、按新结构重写一遍。Iceberg 直接把这件事变成了元数据操作:给表加一列、删一列、改字段类型,只是更新 metadata 里的 schema 记录,并给新 schema 分配一个版本号,数据文件一个都不用动。新写入的数据用新 schema,老文件继续用老 schema,查询时引擎按字段 ID 把列对起来,缺的列读作空值。分区演进同理,新数据按新分区规则写进新布局,旧数据留在原地,各版本的分区元数据分开保存。
时间旅行:回到表过去的某个版本
既然每次提交都生成了一个新快照,而快照之间用 parent_id 串成一条链,那“回到上个月的表”就只是把查询指向链上的某个历史快照。Iceberg 里可以直接写 SELECT * FROM orders VERSION AS OF <快照ID>,或者用 TIMESTAMP AS OF '2025-01-01 10:00:00' 回到某个时间点,还能给快照打 tag、开分支。这直接解决了数据仓库常见的一个需求:指标口径改了,要拿历史数据按新口径重算,或者线上出了错,要回到出问题之前的那个版本对比。
各表格式后续的差异主要在侧重点:Hudi 侧重更新成本和增量处理,Paimon 侧重主键表更新删除,Iceberg 与 Delta 生态则更多在多引擎共享和数据布局上发力。
Hudi:把“更新”变成可控成本,顺带拿到增量
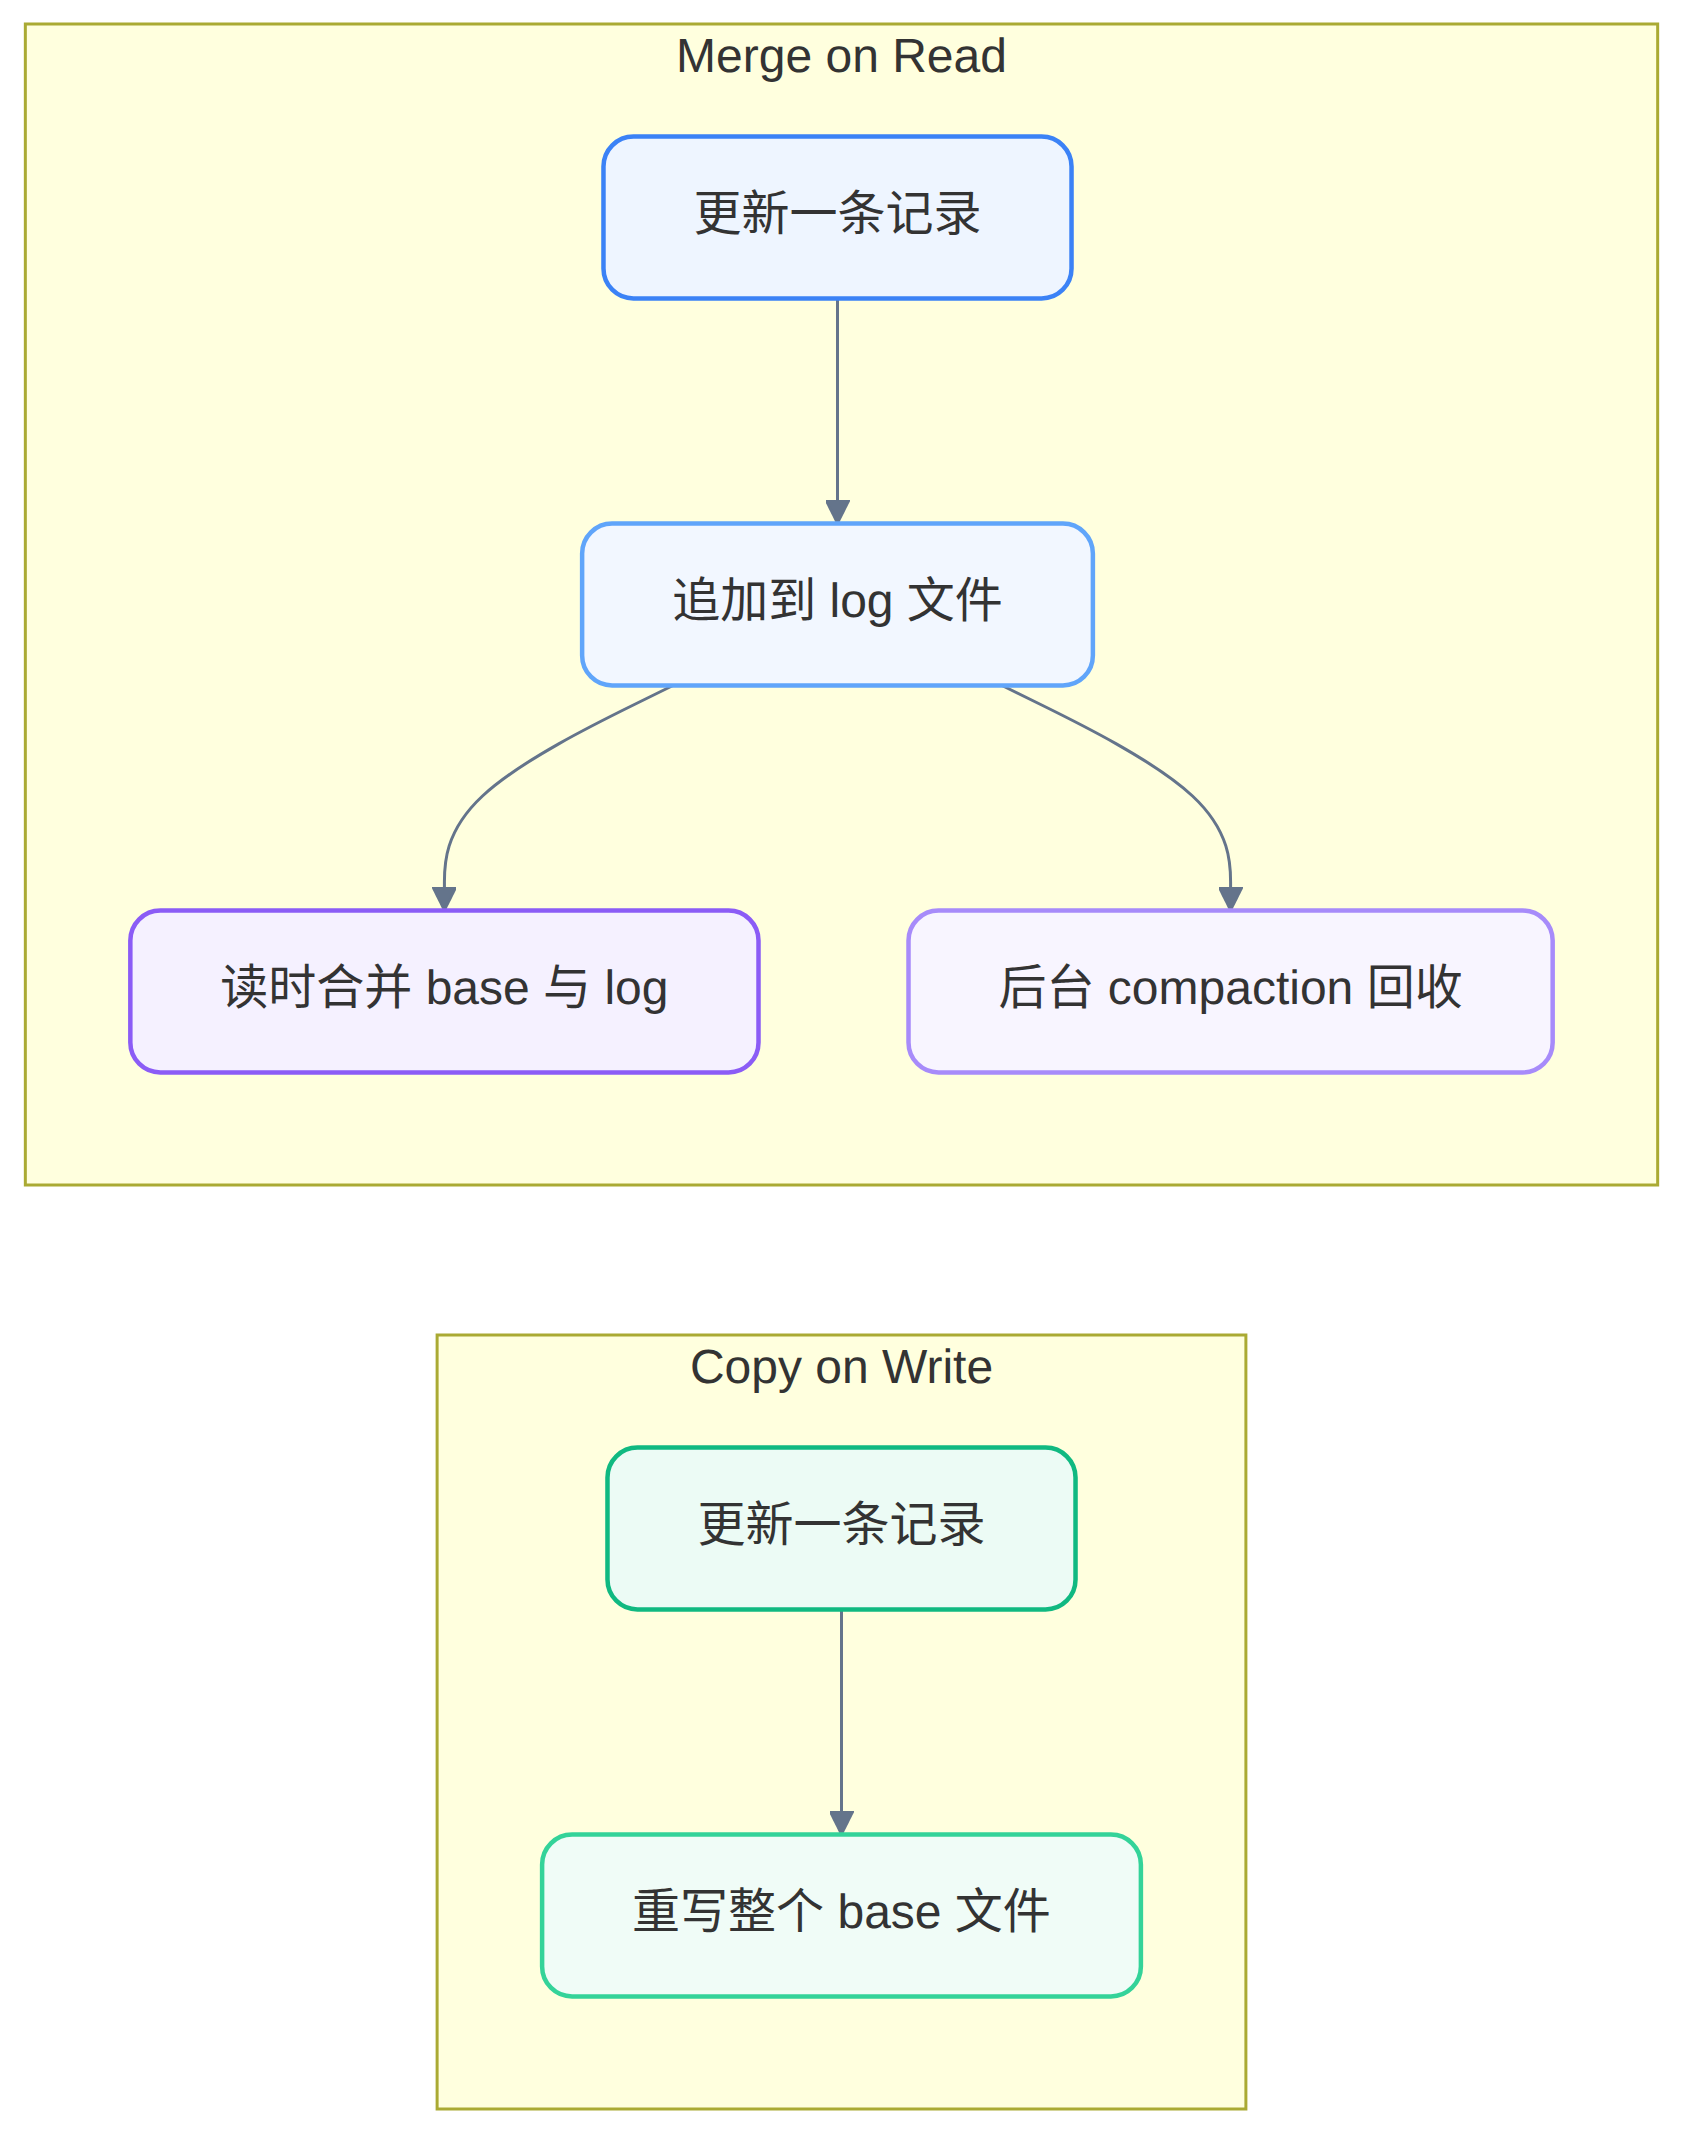
Hudi 最核心的设计是两种表类型:Copy on Write(CoW)和 Merge on Read(MoR),它们把“更新一条记录要花多少代价”变成可选参数。
CoW 只用列式文件。更新一条记录时,它把整个 base 文件读出来、改掉、再重写回去。好处是查询永远只读干净的 Parquet,读得最快;坏处是哪怕只改文件里 1% 的行,也要重写整个文件,写放大很高。所以 CoW 适合读多写少、更新不频繁的批处理场景。
MoR 把写入和读取的成本拆开:更新不再重写 base 文件,而是把改动追加到一个行式(Avro)的 log 文件里,读的时候再把 base 和 log 动态合并。这样写延迟低、更新便宜,代价是读的时候多了一步合并,读放大上来了;于是它靠后台的 compaction 定期把 log 合并回 base 文件,重新找回读性能。两条路线的差别见下图。
Hudi 还强调一个其他表格式较少提的能力:增量查询。它把每一次提交按时间记在 timeline 上,同时区分了数据的“到达时间”和“事件时间”,于是下游可以只捞“从某个时间点之后新进来或改动的记录”,甚至直接拿到带增删改标记的 CDC 流。这对流式入湖、边写边跑的实时数仓场景特别有用,也解释了为什么很多做实时链路的人会把 Hudi 当成入口。
Paimon:把 LSM 树搬进数据湖
Hudi 的 MoR 已经在用“base 加 log”的办法应对更新了,Paimon 走得更远:它直接把数据库存储引擎里的 LSM 树(log-structured merge-tree,RocksDB 那种底层结构)搬到了文件系统上,专门服务带主键的表。
主键表的关键约束是“同一个 key 只能对应一行逻辑行”。Paimon 的写法和 LSM 一样:新记录先进内存缓冲,排序后刷成新的数据文件;一批批文件堆成多个 sorted run,每个 run 内部按键排序、key 区间不重叠,但不同 run 之间可以重叠,甚至同时含同一个 key 的多个版本。查询时,引擎把相关的 run 合起来,对同 key 的记录按规则归并,最后每个 key 只剩一行。归并用什么规则,由 merge engine 决定:默认 deduplicate 只保留最新一条,partial-update 可以只更新非空字段,aggregation 能把多条累加起来。
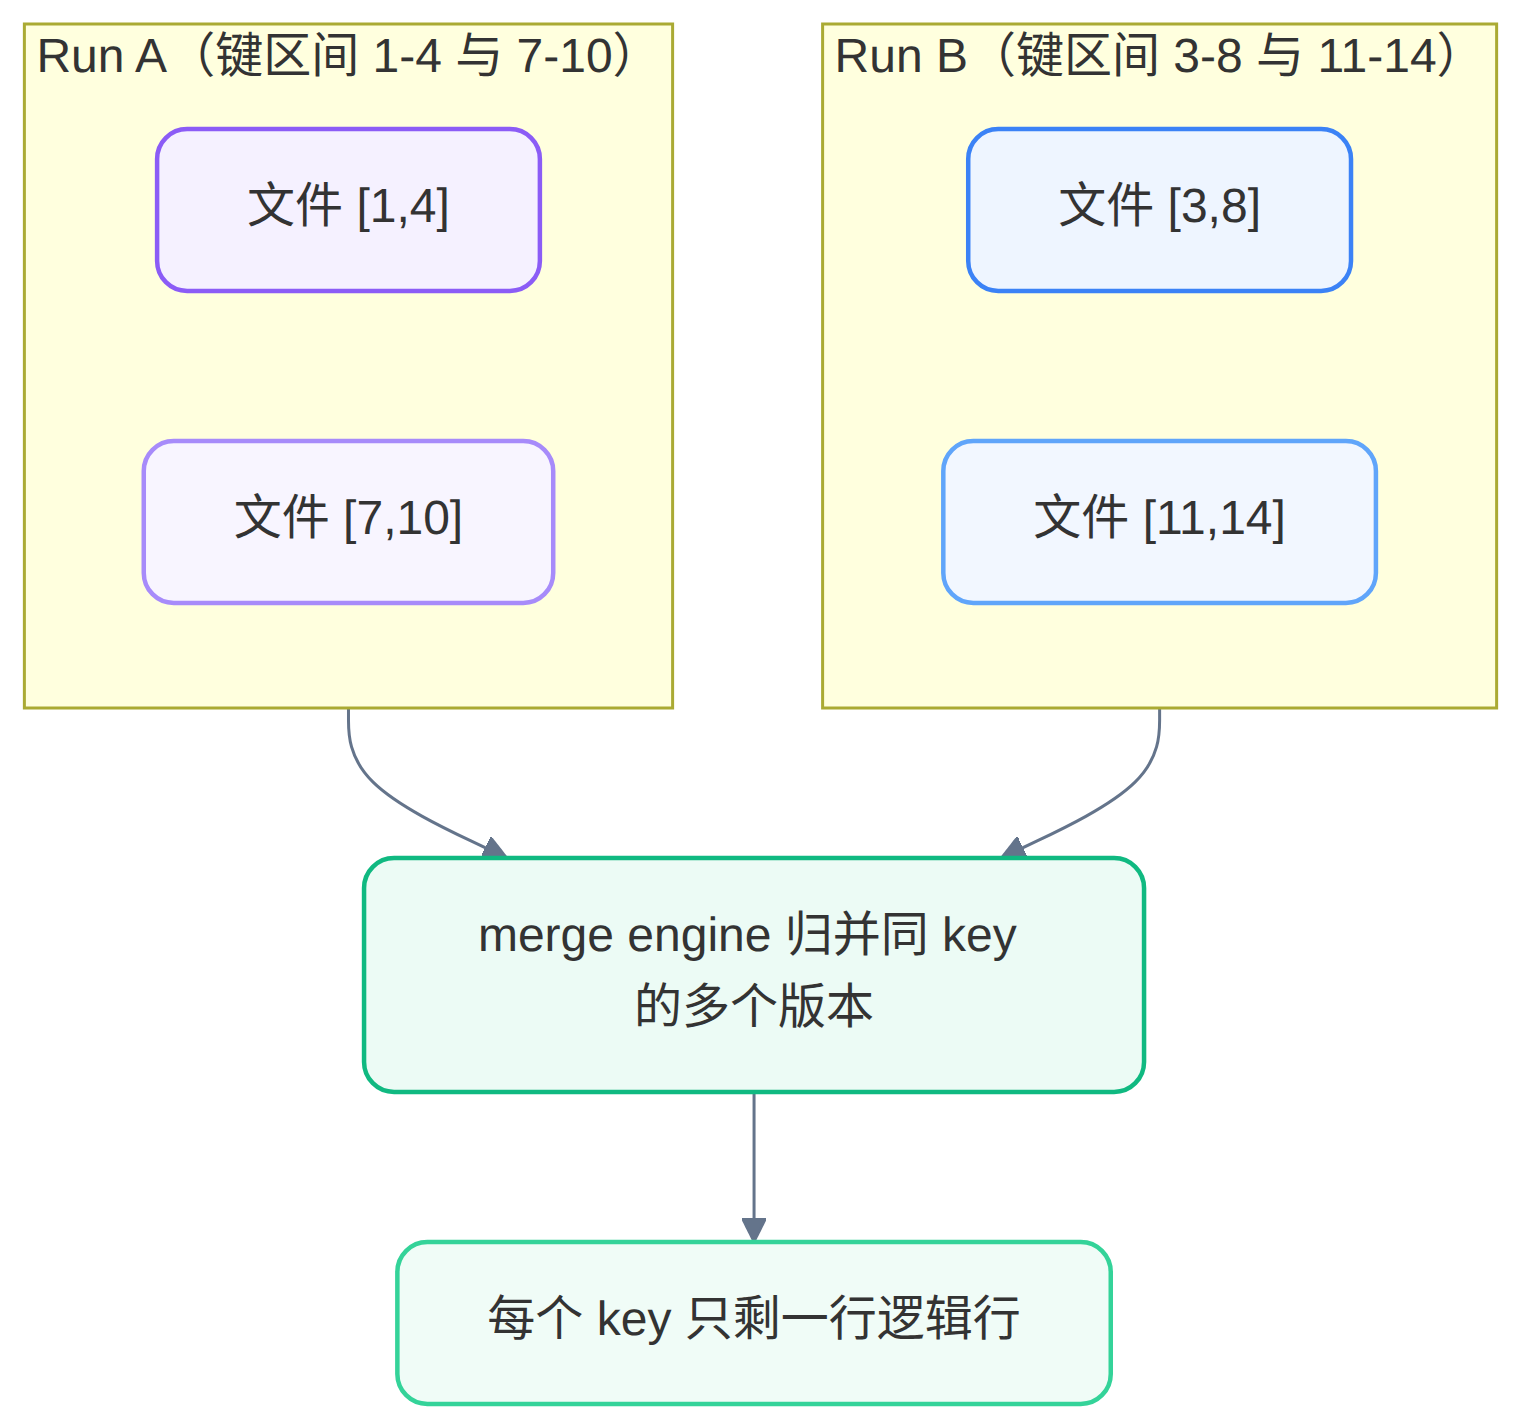
这套设计换来的是数据湖上难得的主键 upsert 和 delete;CDC 同步、订单状态更新这类场景终于不用自己攒一套“去重加删除标记”的逻辑了。代价也很清楚:读的时候要合并多层 run,读放大更高;而且 run 越堆越多会拖慢查询,需要持续的 compaction 在后台把它们归并成更少、更大的文件,这又带来一份运维负担。所以 Paimon 的定位很明确,它擅长频繁按主键更新删除的流式写入,而不是大范围的只读分析。
让同一份数据在 Spark、Flink、Trino 之间自由流转
表格式把数据留在开放的对象存储上,理论上谁都能读。但真正用起来还有一个地方会重新把用户锁住:catalog。它是“表名到表元数据位置”的那张映射——数据文件在 S3 上是开放的,可表注册在哪个 catalog、由谁持有提交,决定了别的引擎能不能真正写它。三家开放表格式都在这一层给了答案,方向一致,取舍不同。
Iceberg:把 catalog 变成 HTTP 服务。 REST Catalog 把 catalog 逻辑放到统一的 HTTP API 后面,Spark、Flink、Trino 各实现一个客户端,就能对接任何实现该协议的服务端;规范还允许服务端下发短时凭证或返回表的最新元数据位置,让引擎不必自己长期保管对象存储密钥。但要注意,规范并不强制“提交发生在服务端”,不少实现只是把请求代理到 Hive Metastore,提交仍在客户端完成,能力边界要按具体实现确认。
Hudi:catalog 可选,表自身可描述。 Hudi 把 commit timeline 写在表目录的 .hoodie 下,表路径本身携带足够的元数据,支持 Hudi 的引擎拿到路径就能读;catalog(Hive Metastore、AWS Glue、JDBC)主要负责让引擎按表名发现表,而不是数据的唯一宿主。多写入者的并发由锁提供者(HMS 锁、DynamoDB 等)兜底,不依赖某个 catalog 独占提交权。
Paimon:先文件系统,再中心化。 Paimon 默认的 filesystem catalog 不需要任何中心服务,靠表目录与 schema 文件即可定位表,天然适合多引擎按路径接入;需要统一命名空间时,再切到 Hive Metastore、JDBC,或自带的 paimon-service 提供的 REST 接口。
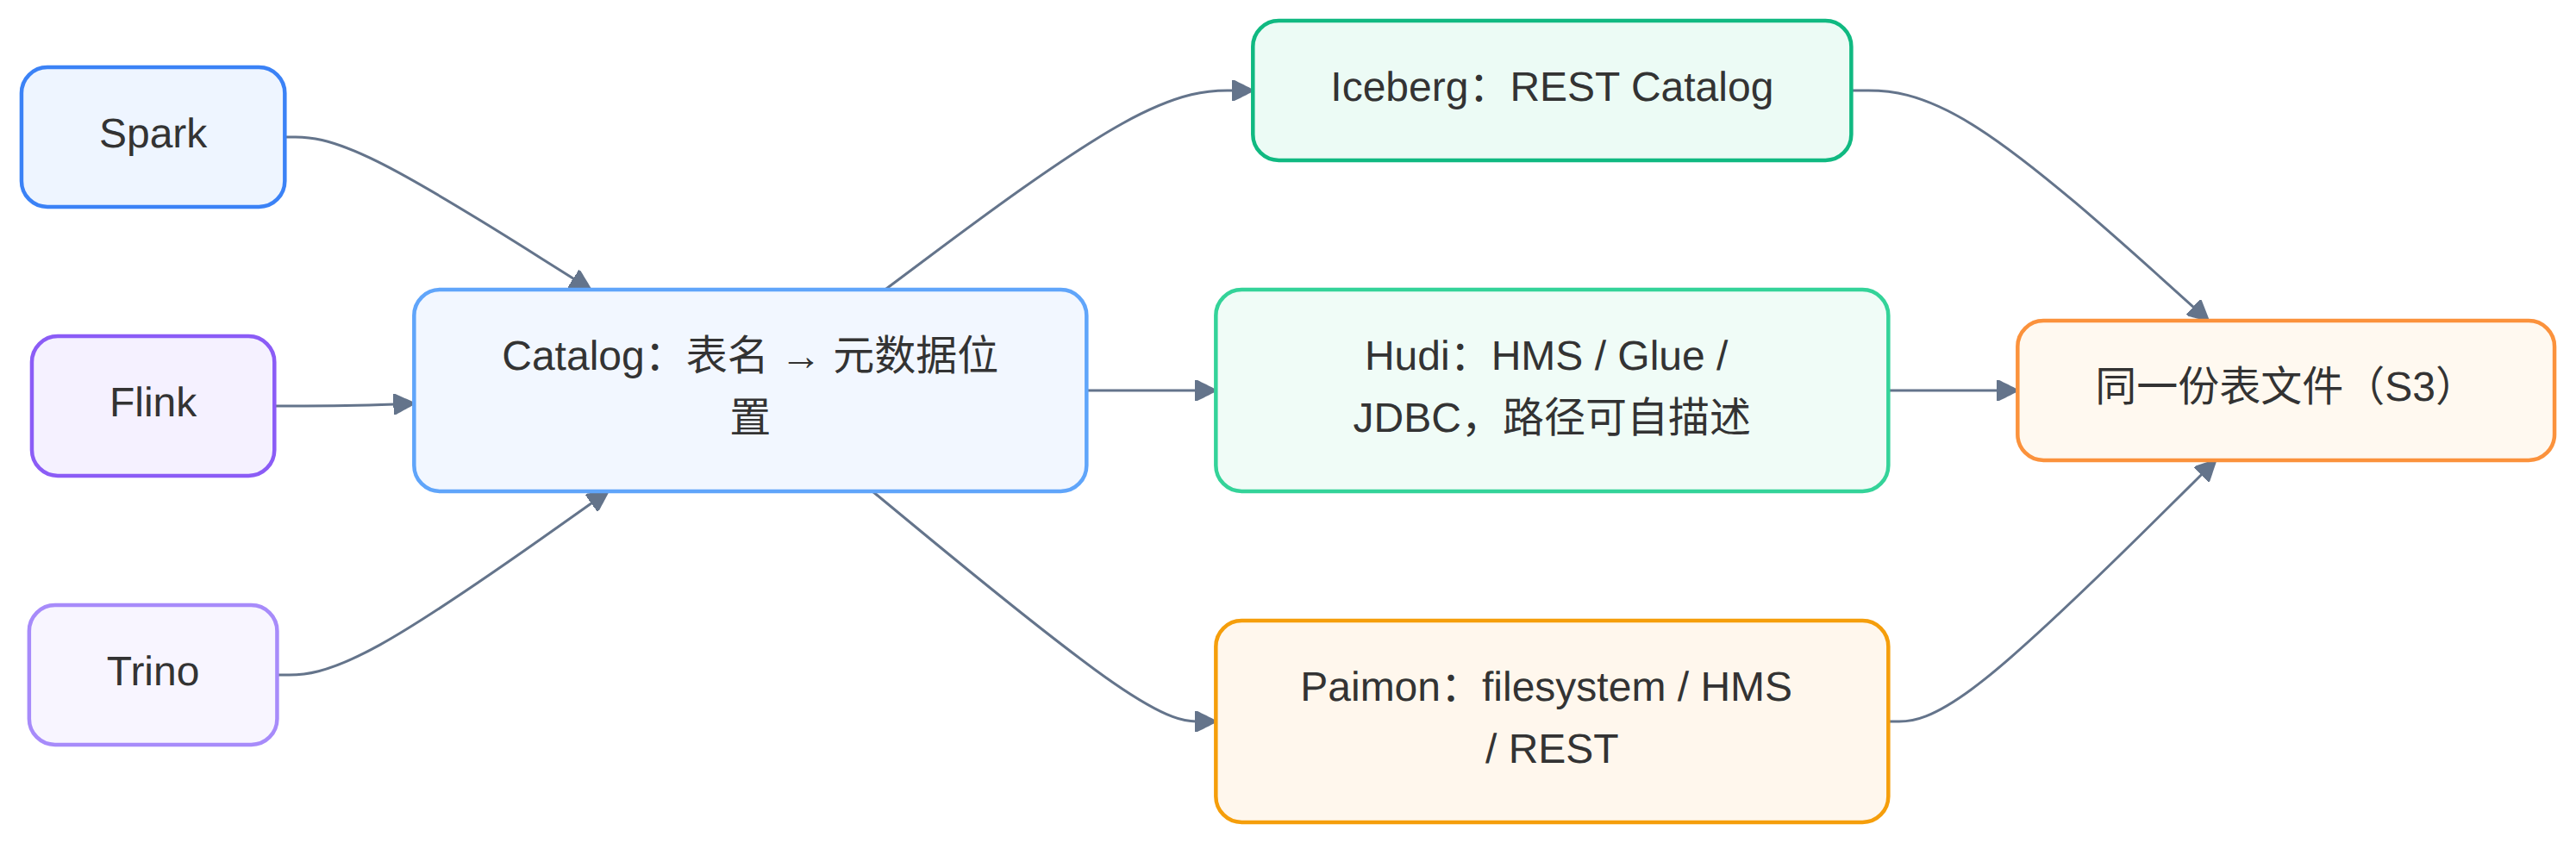
catalog 还会带来一种更隐蔽的锁定:表注册在某家 catalog 里,想搬到另一家云、另一个 catalog,直接 DROP TABLE 可能连数据一起删掉,只 REGISTER(在目标 catalog 挂个名、不搬数据)又会让两个 catalog 都以为自己是这张表唯一的主人,谁先写就 fork 出两张互不知情的表。Iceberg REST 的做法是删表时带 purgeRequested=false,只摘名单不删文件,再拿最新元数据位置去目标端注册;Hudi、Paimon 因为表目录自带元数据,也支持按路径搬迁后重新登记。避免锁定的关键只有一条:这张表能不能干净地从一个 catalog 摘下来,再挂到另一个上而不丢提交历史。
数据怎么存:分区、ZOrder 还是 Liquid Clustering
表格式的最后一层取舍,是数据文件在存储上怎么放,它直接决定查询要跳过多少无关文件。这里有三种典型的布局思路。
分区是最老也最直观的:按某列的取值把数据分到不同目录,比如按日期分目录,查某一天就只扫那一个目录。问题是分区列必须基数低、边界固定,选错了列要么产生海量小文件,要么数据严重倾斜;而且分区规则定下来很难改,改分区基本等于重做表。
ZOrder 是 Delta Lake 里另一条路:对几列做多维排序,把取值相近的行聚到同一批文件里,让按这几列过滤时能跳过更多文件。它比分区的多列过滤更灵活,但聚类质量有限,同一列的值可能散在很多文件里,而且每次重排都要重写大量数据。
Liquid Clustering 是 Databricks 在 Delta Lake(以及其托管 Iceberg 表)上给的新方案:你只要用 CLUSTER BY 声明要按哪些列聚类,平台自己决定文件怎么摆;关键是可以随时改聚类列而不用重写存量数据,OPTIMIZE 也只是增量地重排新数据,高基数、易偏斜的列也能用。它想同时解决分区规则过死、ZOrder 维护成本高和聚类质量有限的问题;但它属于 Databricks 产品内的能力,受相应运行时版本和协议限制,不能直接搬到其他表格式上。
选哪条,就看负载:查询基本按一两个低基数列(比如日期)过滤的,分区就够了;查询经常按多个维度一起过滤的,ZOrder 或 Liquid Clustering 更合适;数据天天在涨、访问模式还会变的,声明式、可增量维护的 Liquid Clustering 优势最明显。综合来看,Hudi、Iceberg、Paimon 被广泛采用的原因很直接:数据继续留在开放的对象存储上,只需补一层管理文件增删和版本的元数据,就能获得仓库级的可靠性,也减少了被单一引擎或云锁定的风险。
评论