
ETL与ELT有什么区别:先看主要转换在仓外还是仓内
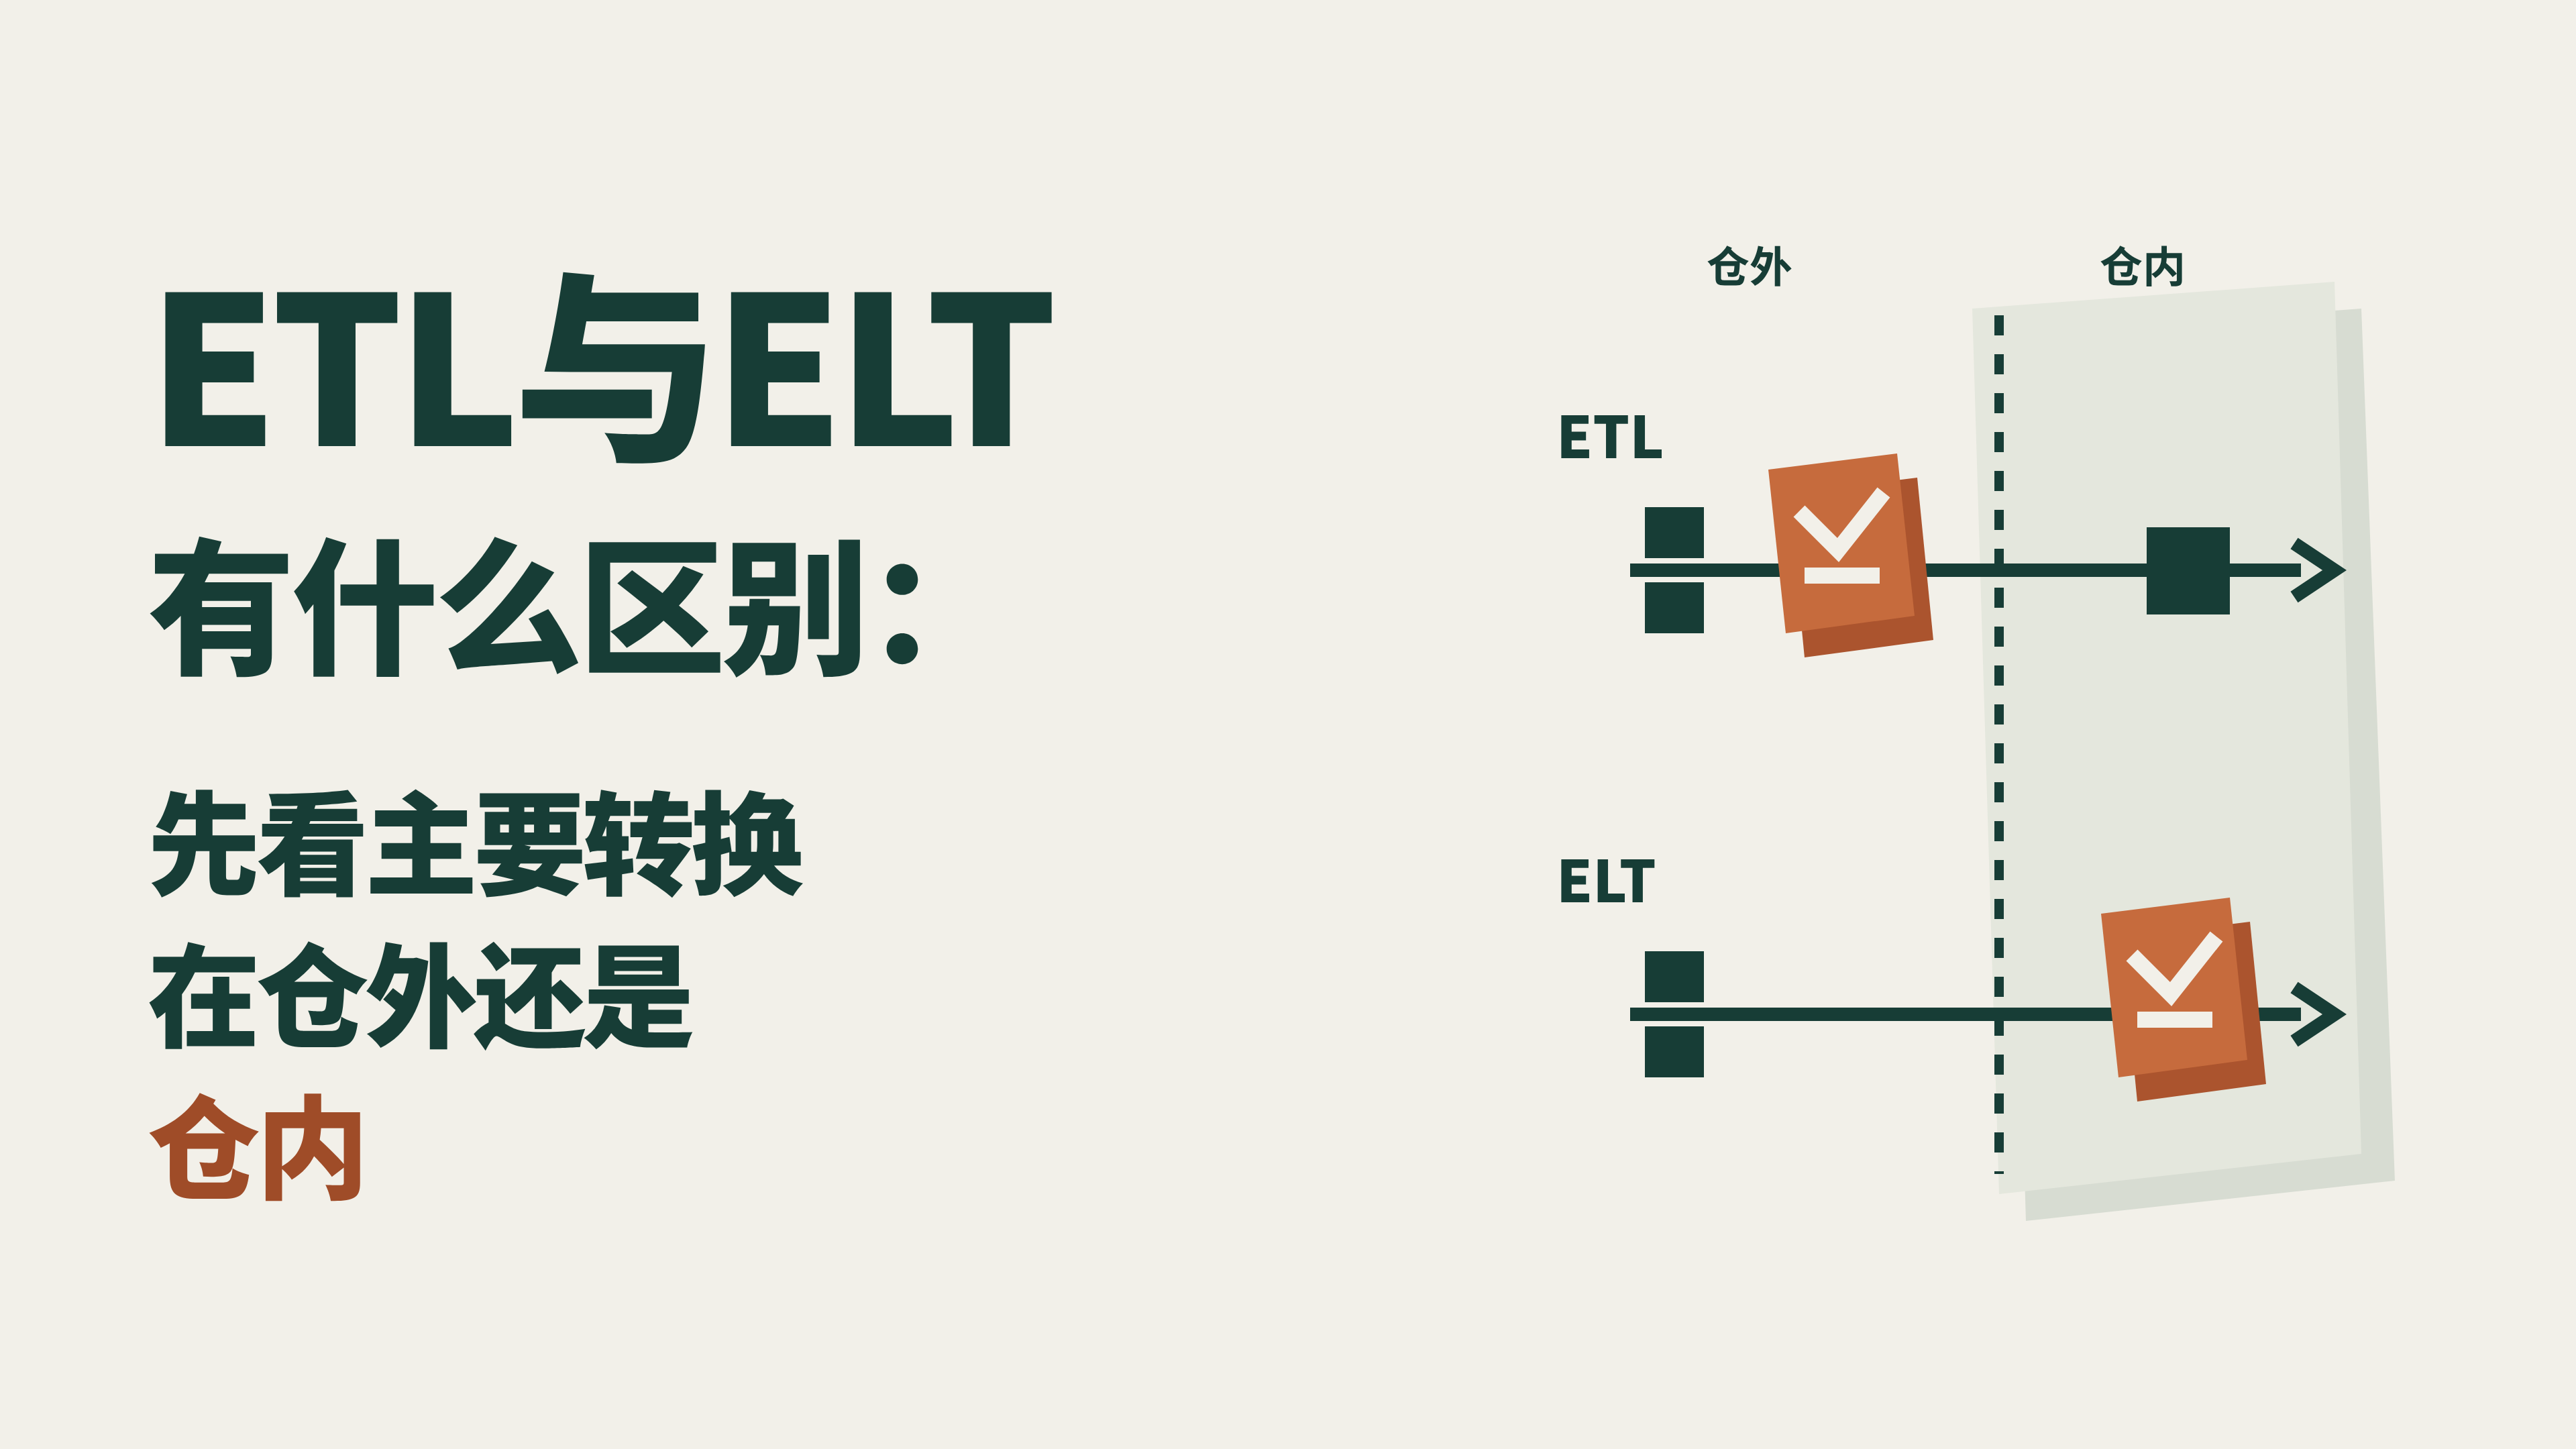
同样要把订单数据送进数据仓库,为什么有的流程先加工再入仓,有的却先入仓再加工?差别在于:主要转换由哪里执行,以及数据进入目标系统时已经处理到什么程度。ETL在把数据加载到目标系统之前完成主要转换,ELT则先把数据加载到目标系统,再利用目标系统完成主要转换。这一顺序会影响计算资源的使用、数据检查的位置,以及需求改变后从哪里重新计算。
先确定加载到哪里,才能分清ETL和ELT
订单系统记录交易,分析人员则需要统计支付金额。把记录复制过去,只完成了数据移动;要得到金额统计,还得识别重复记录、筛选支付状态、统一金额单位。这些加工就是转换。
三个字母各自对应一个动作:E是Extract,抽取,即从来源读取所需数据;T是Transform,转换,即按规则改变数据的格式、内容或组织方式;L是Load,加载,即把数据写入目标系统。ETL的全称是Extract、Transform、Load,ELT则是Extract、Load、Transform。
两条路径的主要计算位置如下,箭头表示数据的处理顺序:
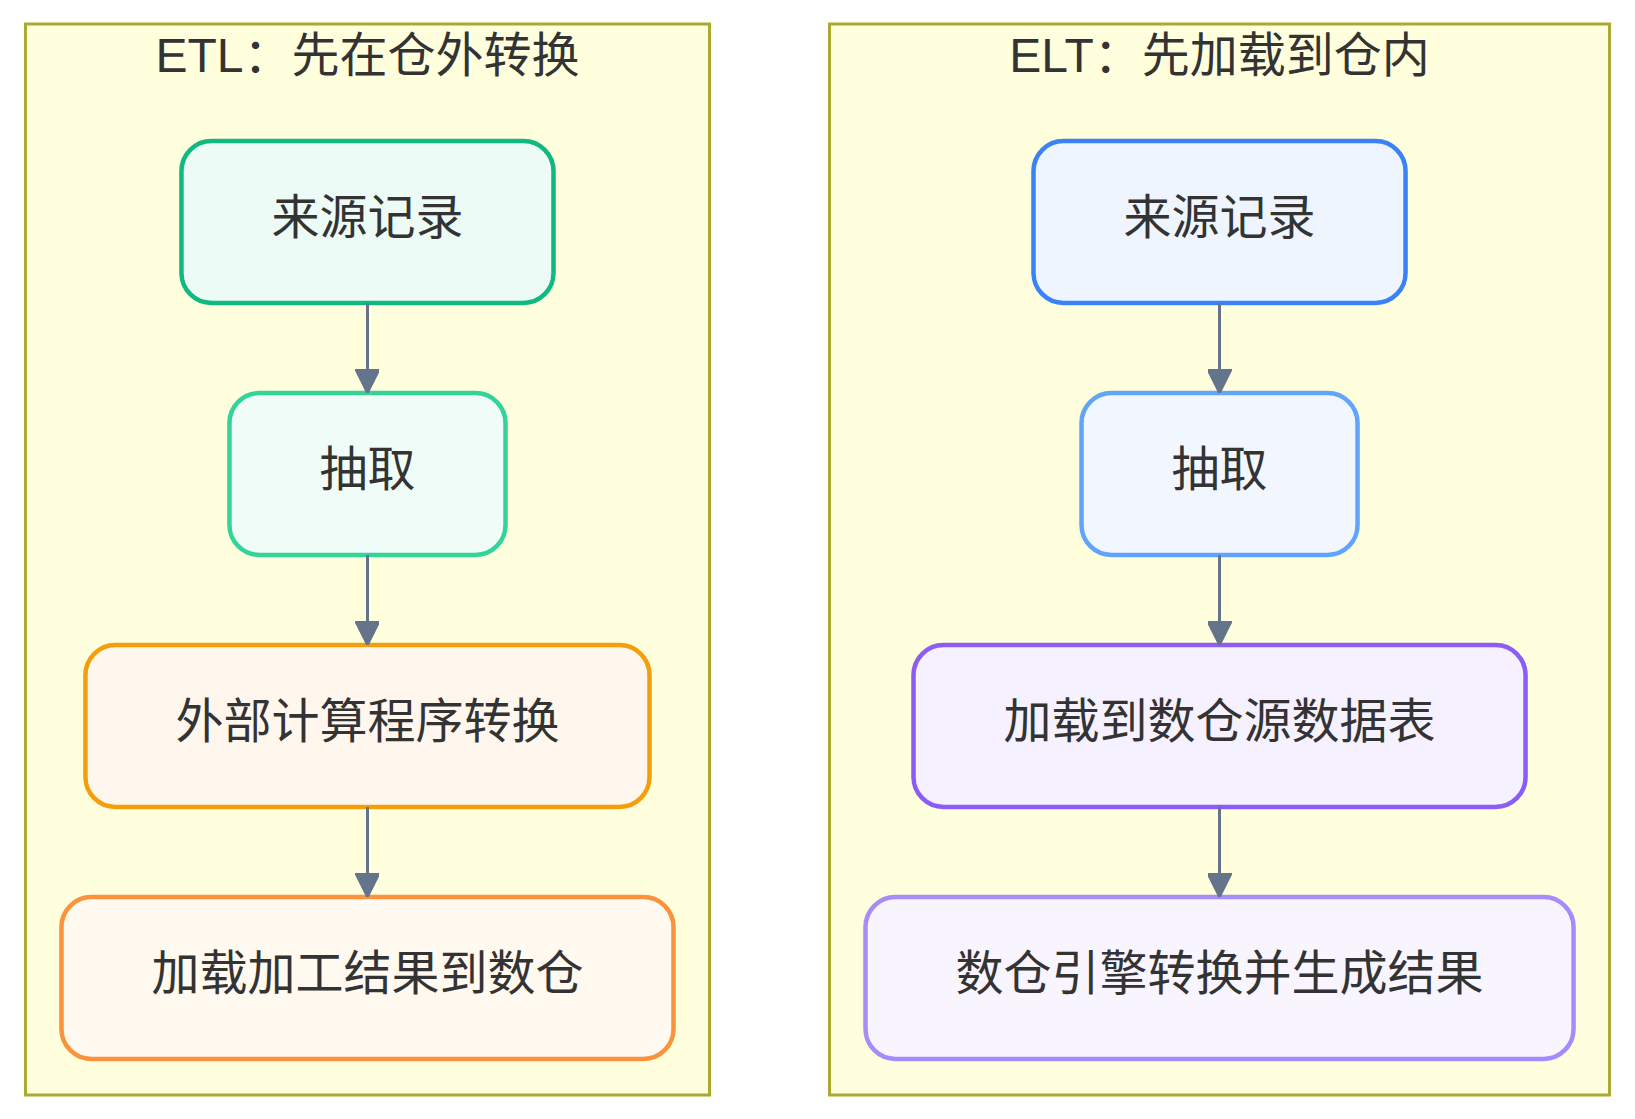
ETL路径中,外部程序可以先算出支付金额,再把结果写入仓库。ELT路径中,仓库先收到来源数据,随后仓内引擎读取源表,完成筛选和计算。源表是先接收数据、供后续加工使用的表;它与供报表读取的正式结果表承担不同任务。
可以把目标系统想成一家餐厅的厨房:蔬菜在外面完成主要切配再送进厨房,对应ETL;蔬菜先送进厨房的备料区,再由厨房人员完成主要切配,对应ELT。备料区对应源表,切配对应主要转换。判断两条路径,关键是主要切配发生在厨房外还是厨房内,而不是中途有没有放进过某个筐。
判断顺序时,必须认清当前讨论的目标。ETL程序把抽取的数据临时写成文件,随后加工并装入仓库,临时文件的保存并没有把它变成ELT。反过来,ELT把数据加载到仓内源数据表后,再把转换结果写入正式表,后面这次写表也没有改变主要转换发生在仓内的事实。
“先加载”也要满足加载接口的要求。例如文件分隔符、字段排列和数据类型必须能被目标识别,必要的格式准备仍然可能发生在加载前。区分两者时,关注支付筛选、金额计算等主要转换在哪里完成,比要求每个字节入仓前都毫无变化更有用。
同一组订单,两条路径怎样得到相同结果
假设一次抽取拿到了以下四行记录。每行原本表示一笔订单,A01因重复传输出现了两次,而且两行的所有字段完全相同。金额字段amount_cent的单位是分,状态PAID表示已支付,CREATED表示已创建但未支付。
| 订单编号 | amount_cent | 状态 | 渠道 |
|---|---|---|---|
| A01 | 12000 | PAID | APP |
| A01 | 12000 | PAID | APP |
| A02 | 8000 | PAID | WEB |
| A03 | 5000 | CREATED | APP |
目标是计算这批订单的已支付金额,单位为元。规则依次是:删除完全重复的记录,保留已支付订单,再把分转换为元。四行先变成三笔不同订单,筛选后剩A01和A02,金额分别为120元和80元,合计200元。如果把重复的A01也累计进去,就会得到320元。
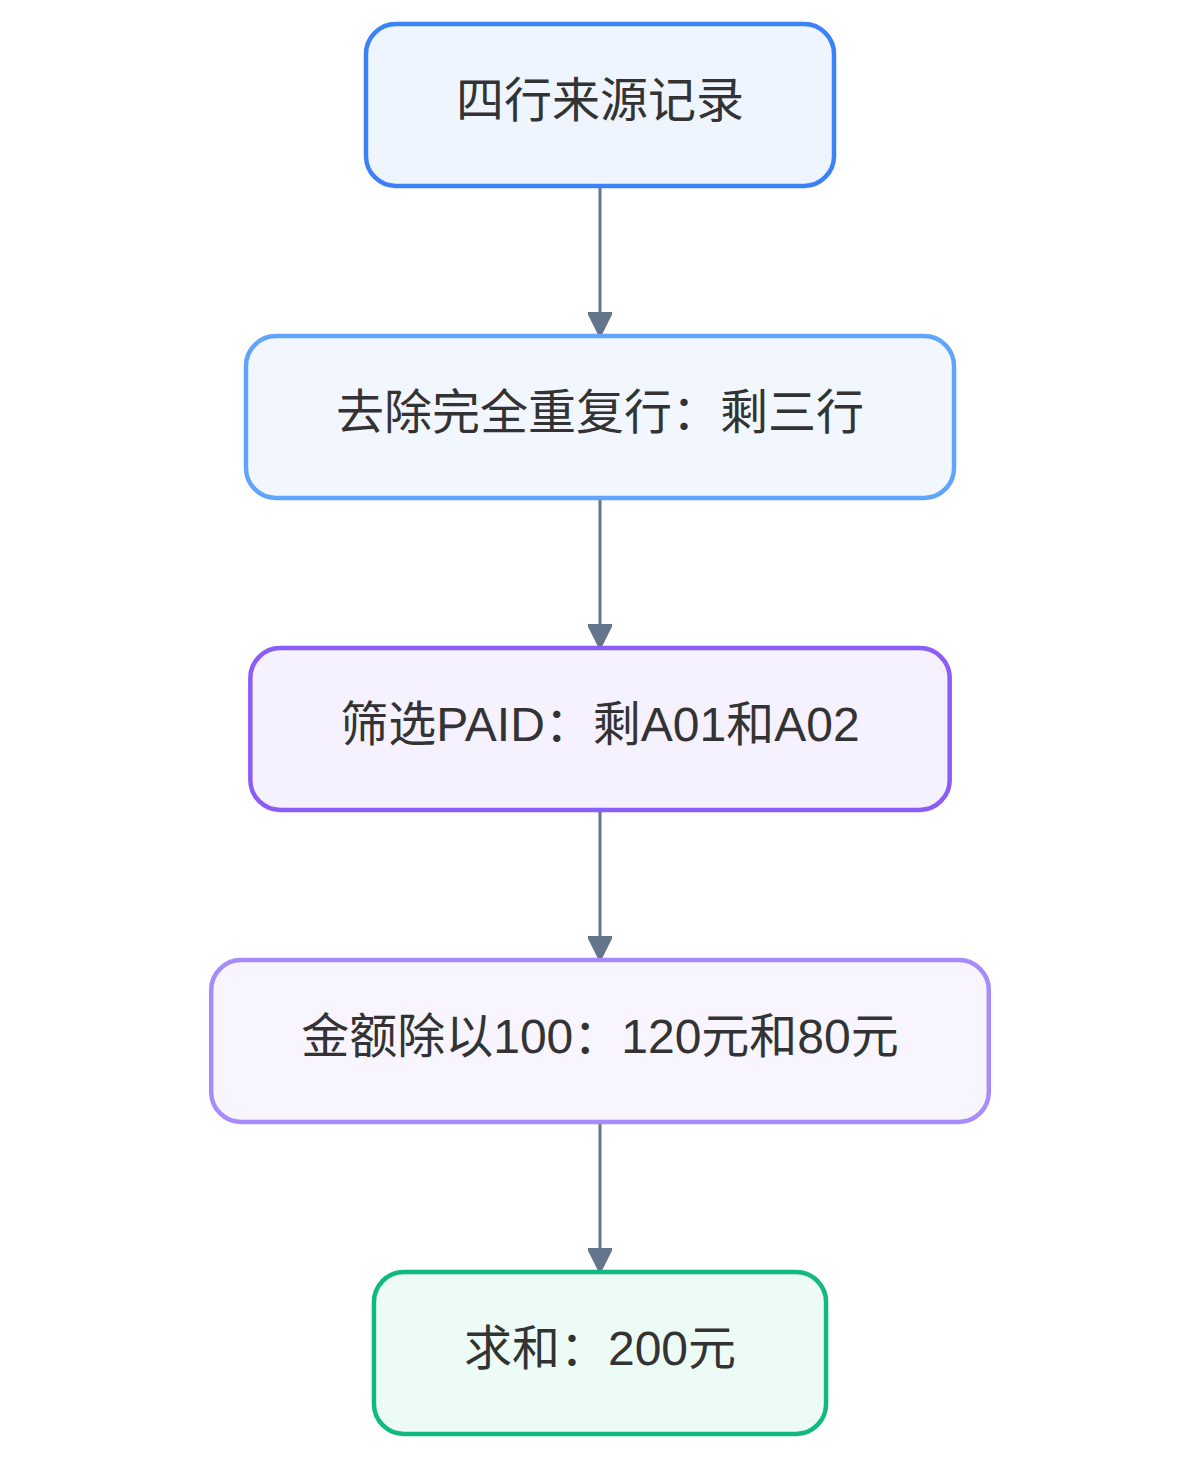
ETL让仓外程序执行图中的转换,然后加载两笔已支付订单明细,或者加载200元的统计结果;加载到哪一种粒度,要看下游需要什么。ELT可以先把这四行写入仓内的raw_orders源数据表,再由仓内SQL执行同样的规则。两条路径的输入和业务规则相同,就应得到相同的200元,处理位置本身不会改变支付金额的定义。
下面的SQL读取已经加载的raw_orders表。该表包含order_id、amount_cent、status、channel四个字段,内容正是上表;金额字段保存合法的整数值。
WITH unique_orders AS (
    SELECT DISTINCT order_id, amount_cent, status, channel
    FROM raw_orders
), paid_orders AS (
    SELECT order_id, channel,
           CAST(amount_cent AS numeric) / 100 AS amount_yuan
    FROM unique_orders
    WHERE status = 'PAID'
)
SELECT SUM(amount_yuan) AS paid_amount_yuan
FROM paid_orders;
DISTINCT去掉四个字段都相同的行,WHERE筛选支付状态。CAST把金额转换成可进行小数运算的类型,再除以100;SUM把两笔金额相加。两个带名称的查询部分只用于组织计算步骤,这条查询本身没有把处理结果写成新表;需要保存结果时,还要执行相应的写表操作。
这里能按整行去重,是因为重复行已明确为同一笔订单的完全重复副本。如果两行A01金额不同,就需要先判断它们是订单更新、不同业务明细,还是错误记录;上面的DISTINCT会把它们都留下。业务规则要先解释这些记录的含义,再决定保留哪一行。把转换移进仓库,并不能替团队作出这个判断。
需求改变后,能否重算取决于保留了什么
总额已经是200元,第二天又要按渠道拆开:APP收了多少,WEB收了多少?如果手里只有一个200元的数字,就无法还原120元来自APP、80元来自WEB。就像购物小票只剩合计金额,无法再从合计中拆出水果花费;必须还保留各项明细。回到订单数据,能否按渠道重算,取决于可用记录里还有没有订单金额、状态和渠道字段。
如果ELT加载的四行来源记录仍然保留,仓内程序可以重新读取它们,按相同规则去重、筛选并把分转换为元,再按渠道分组求和。GROUP BY channel的含义是把渠道相同的行放在一组中累计。处理后APP为120元,WEB为80元,两个渠道相加仍为200元。
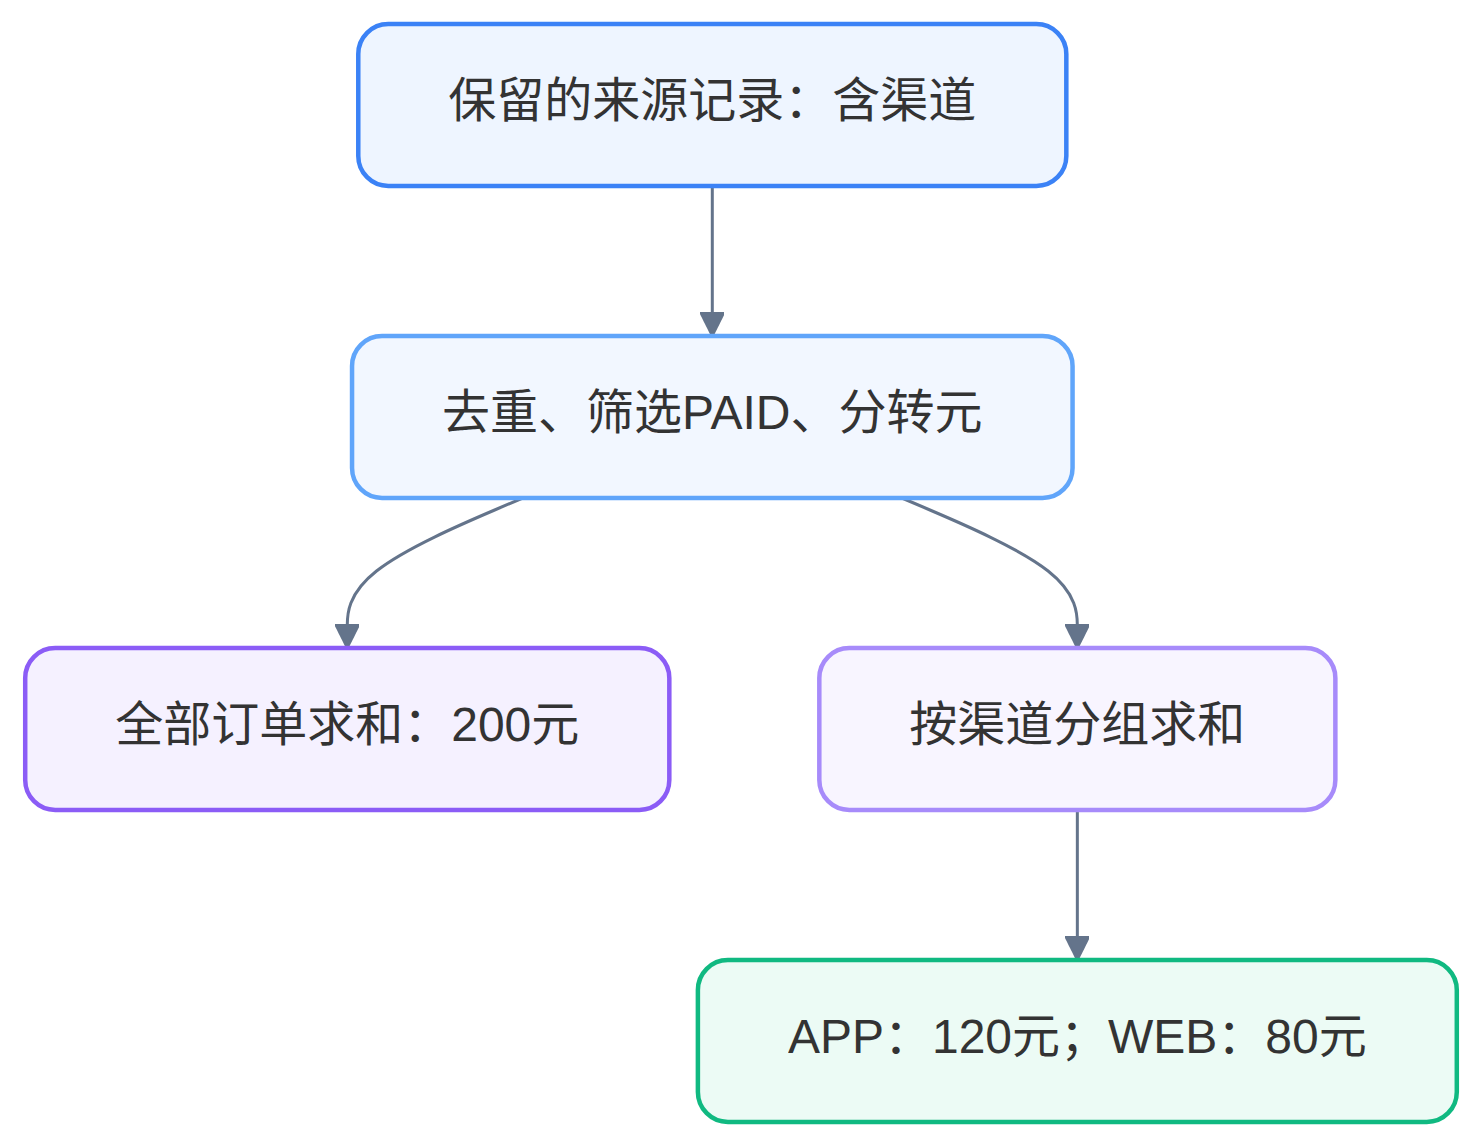
ETL也能满足这个新需求。它若先前已经加载了含渠道的两笔已支付订单明细,就可以从这些明细重新汇总;若另外保留了抽取文件,也可以由外部程序重新加工。只有在仓内仅剩总额、外部又没有所需输入时,才需要重新向来源获取数据。是否留明细、留哪些字段,与转换放在哪里是两个相关但不同的设计决定。
ELT的便利在于,数据进入目标系统后,后续转换可以直接基于这份已入仓的数据进行。但“已经加载过”不能证明今天仍能重算:源数据表若已清空,或渠道字段当时根本没采集,新需求仍然缺输入。需要支持一段历史的重新计算,就应保留那段历史所需的记录和字段;保存多久,要与实际重算范围对应。
同样要区分“数据已加载”和“分析结果已完成”。ELT源数据表中出现四行记录时,原始接入可以算完成,200元的结果却还没有计算出来。如果仓内转换失败,报表就不能把这四行当成已经清洗好的两笔订单使用。把两种完成状态分开,才能知道当前要恢复的是数据接入,还是后续计算。
选择ETL还是ELT,先看数据准入、计算位置和成本
选择首先要回答:什么数据允许进入目标系统?假设分析平台不允许保存手机号明文,那么删除这个字段或按既定规则处理它,就必须发生在相应数据进入平台之前。这个条件直接决定了至少一部分转换要在仓外完成。
其次是:由哪里承担主要计算?如果目标系统只适合接收已经整理好的固定格式结果,仓外程序先加工,再交付目标所需数据,ETL更符合这一分工。如果目标仓库能承担所需的筛选、关联和汇总,先加载到仓内再转换,就可以利用仓内引擎完成分析加工。这里要确认的是所需运算能否执行、处理资源能否满足任务时限,而非仅看产品是否叫“数仓”。
两种做法的资源开销也不同。ETL需要安排仓外转换的计算资源,再把加工结果装载进去;ELT则需要在目标平台安排输入存储和后续转换资源。若只比较加载耗时,ELT可能看起来很快,但报表仍在等仓内转换。这就像比较两种备餐方式,不能只看食材何时送到厨房,还要看饭菜何时做好:数据加载完成对应食材送达,分析结果准备好才对应饭菜做好。要比较端到端完成时间,应从抽取开始,一直计算到所需结果准备好;成本也要同时考虑存储、传输与计算。
实际路径还可以混合。对于同一批订单,可以先在仓外删除不允许进入平台的字段,完成必要的格式准备,然后加载较完整的订单记录,最后在仓内计算支付额和渠道统计:
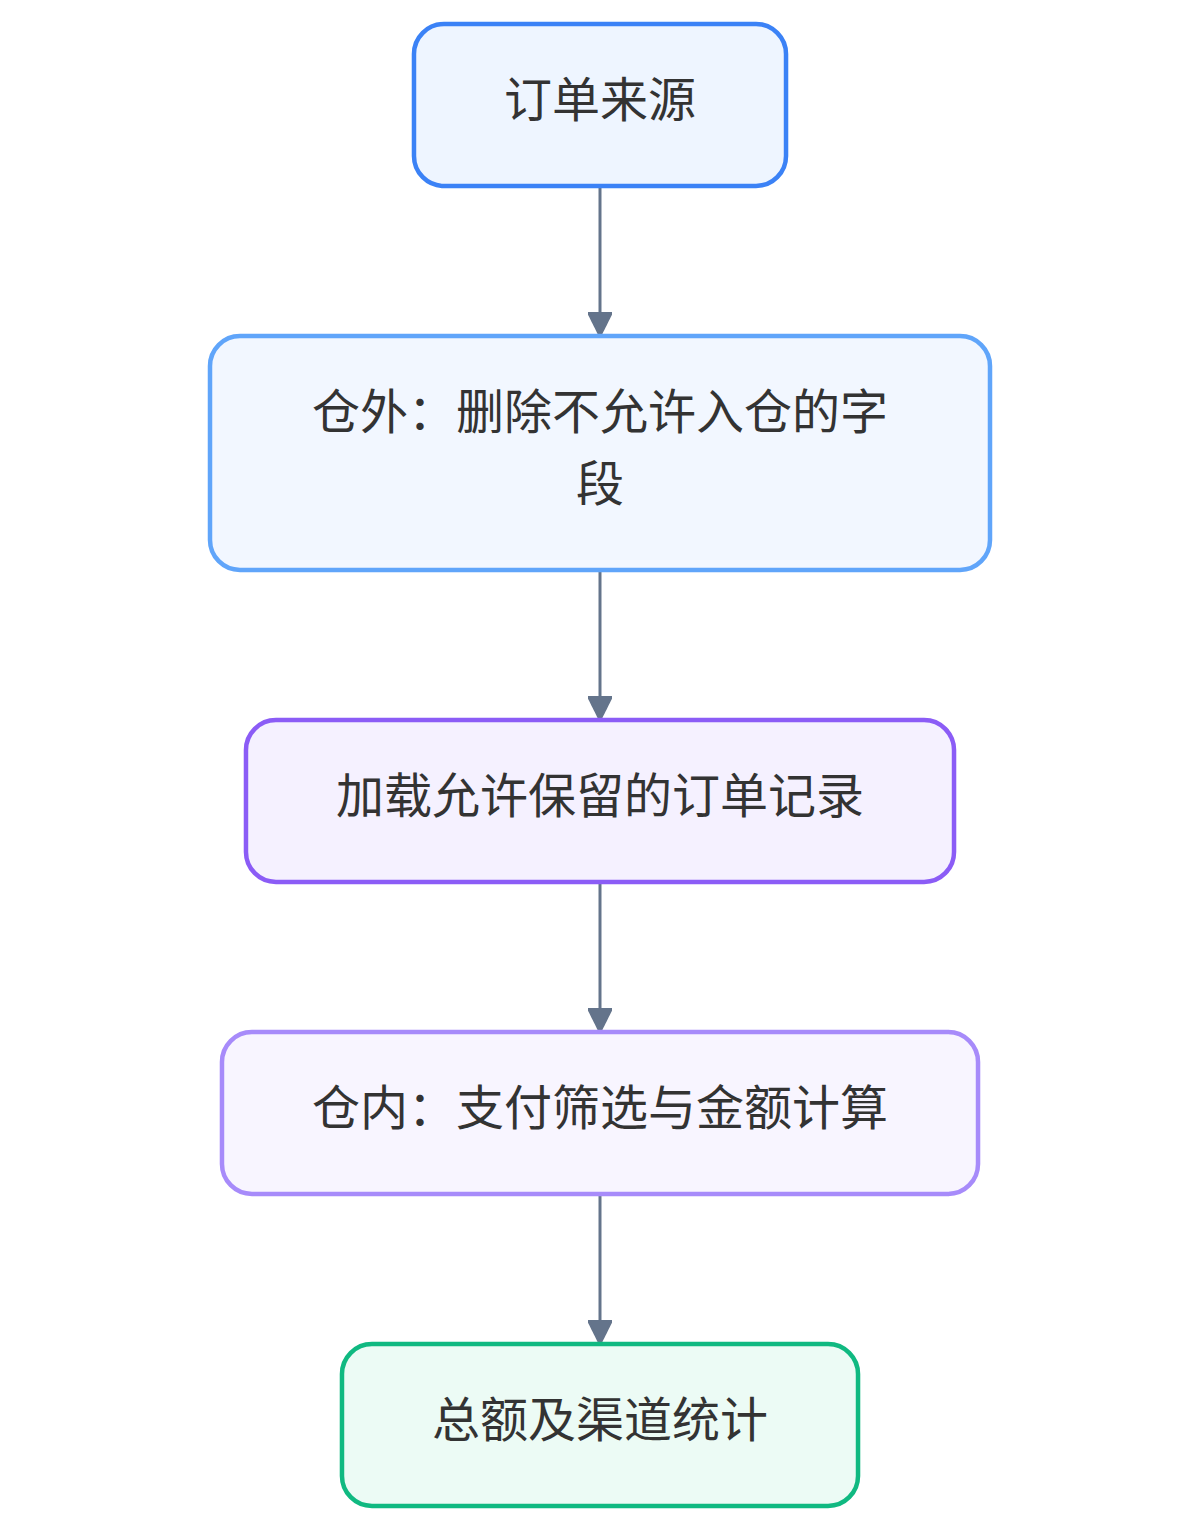
这条路径把数据准入要求放在加载前,把会随分析需求变化的计算放在加载后。判断架构时,标出目标系统的边界,沿一笔记录检查它在哪里被读取、转换和写入,再确认哪些输入会保留。这样才能回答三个字母背后的实际问题:计算由谁承担,结果何时可用,规则改变后还能从哪里重新计算。
评论