
OLTP、OLAP与HTAP:按访问特征区分交易与分析
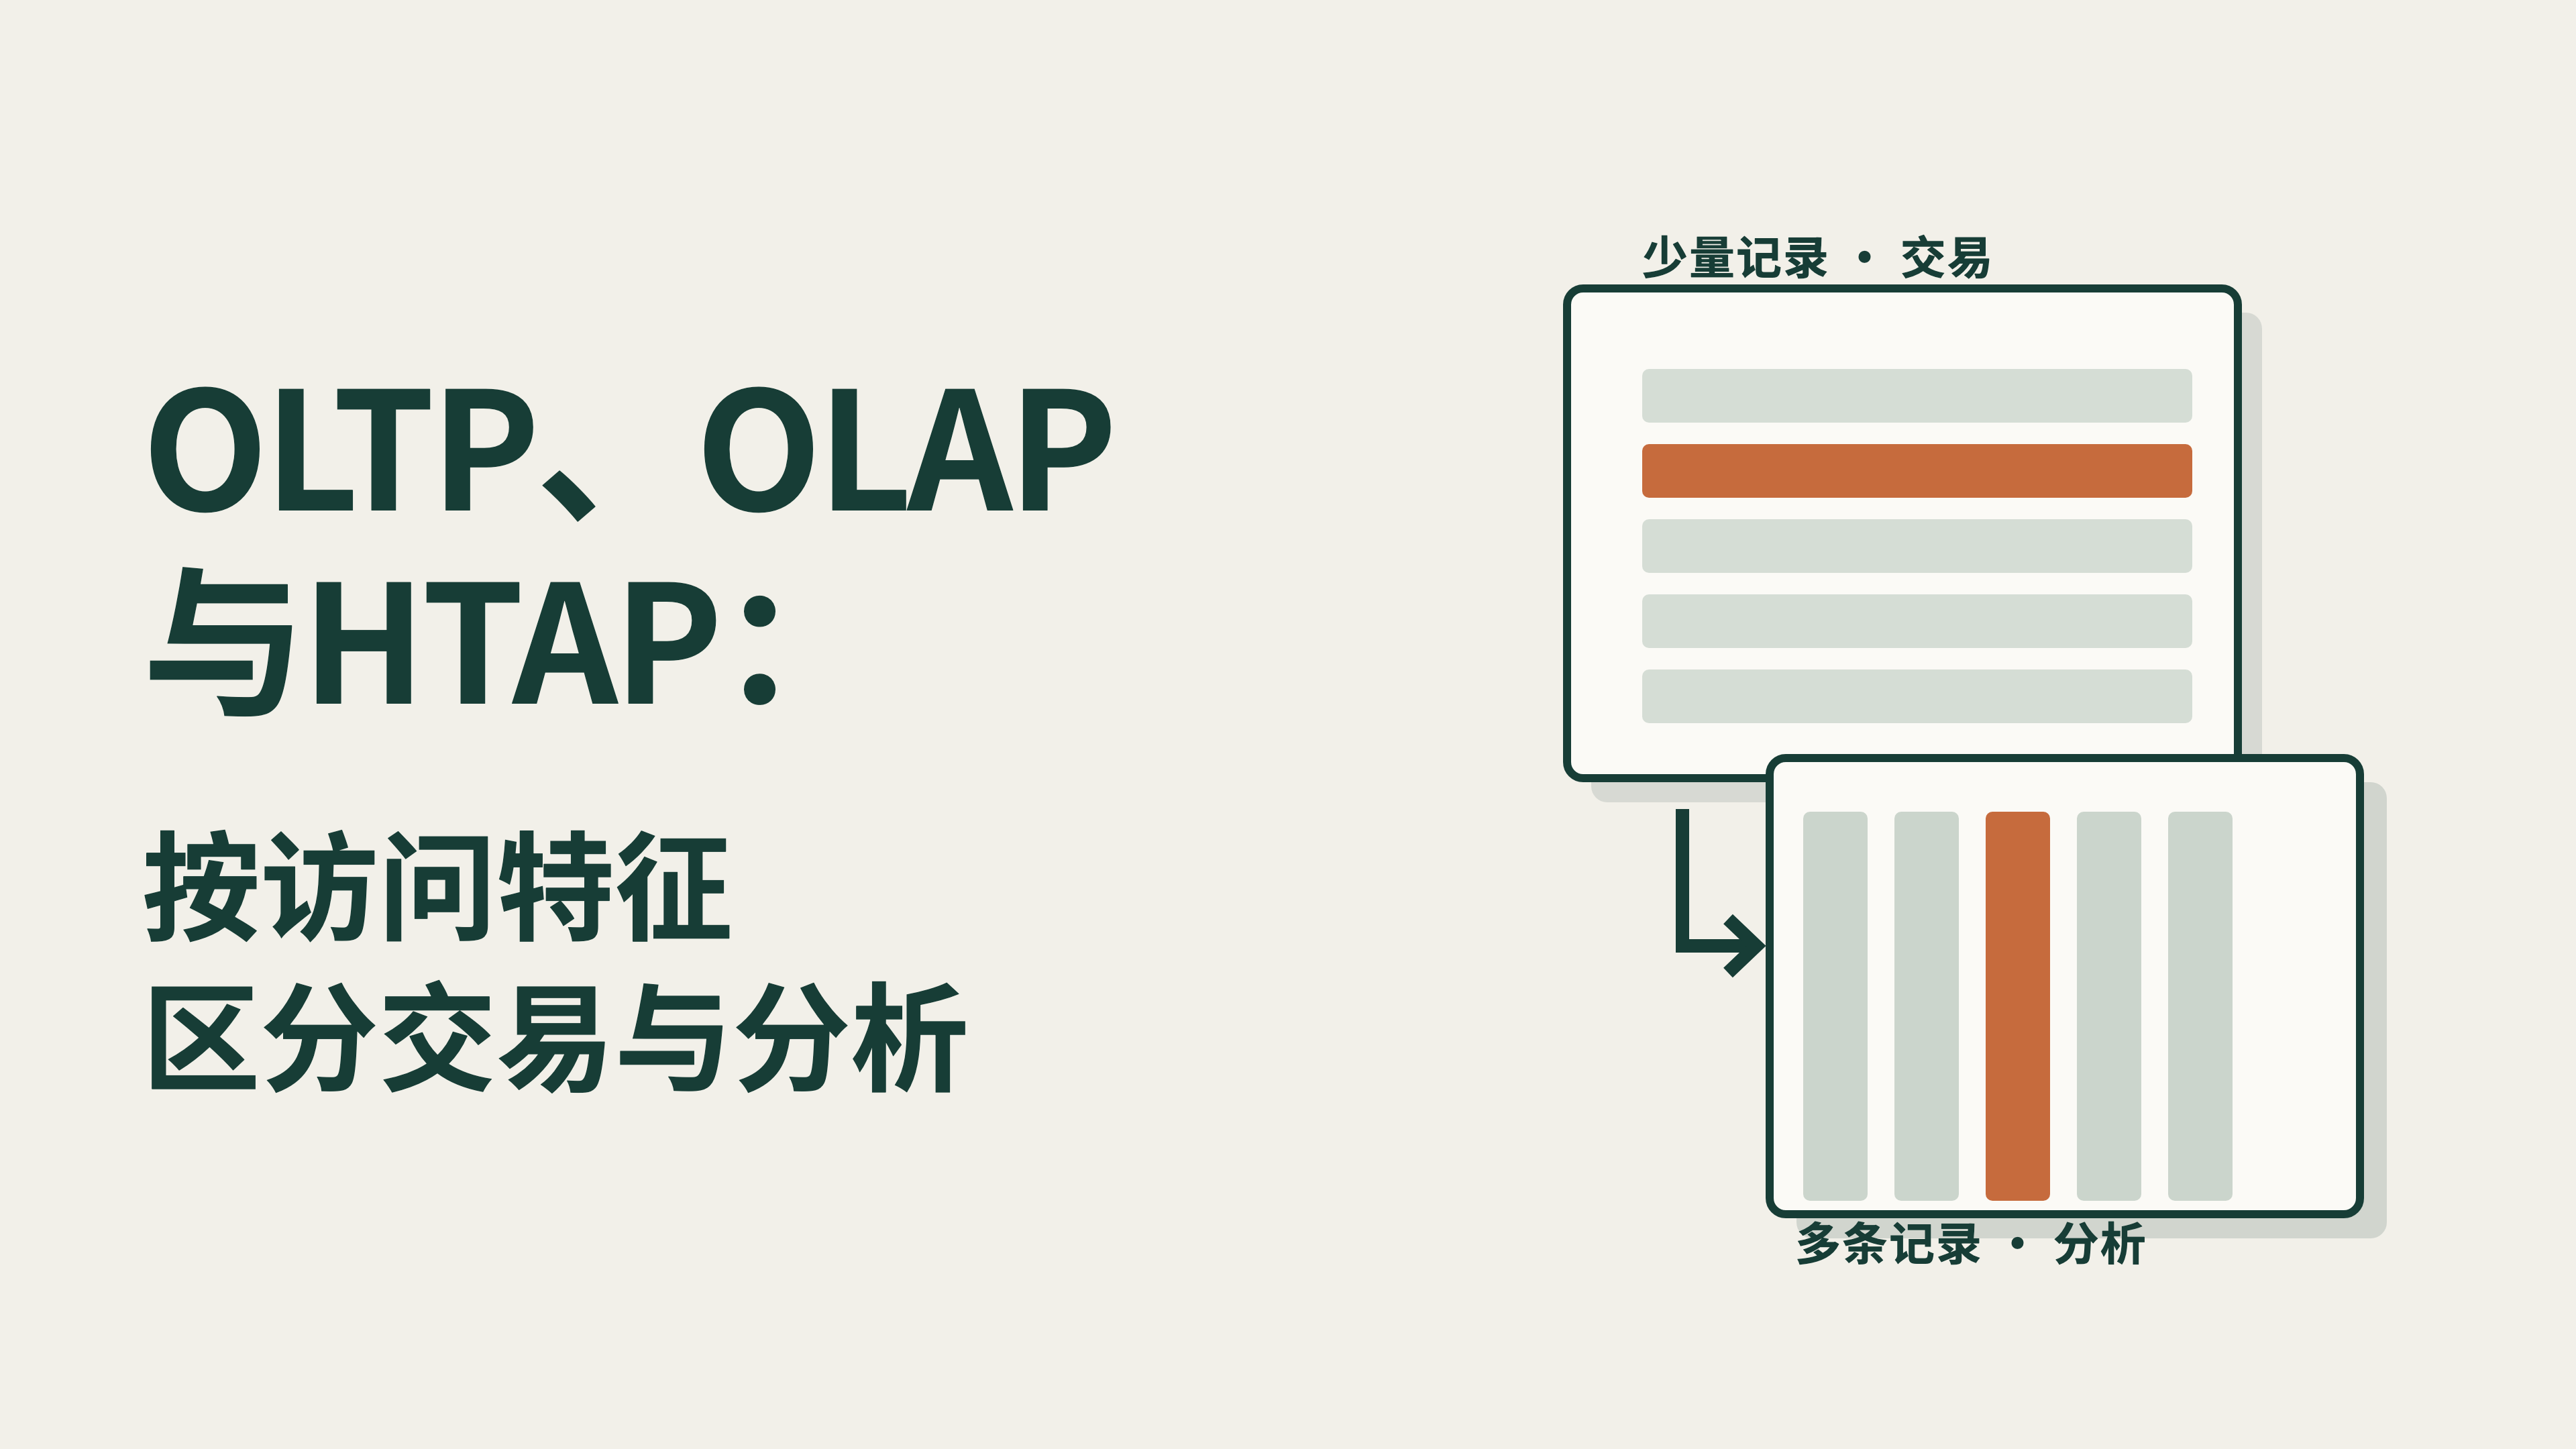
同一张订单表,收银台每秒要往里写进几十笔新订单,财务月底又要从里面算出各地区全年的销售额。同样是“订单数据”,一边担心“别写错、别卡住”,一边担心“别扫太慢”。这背后是两类完全不同的数据处理方式,分别叫联机事务处理(Online Transaction Processing,OLTP)和联机分析处理(Online Analytical Processing,OLAP)。它们的差别不在谁快谁慢,而在一次操作要读写多少记录、关注的是事务内的状态一致还是跨记录统计。还有人将两种诉求整合到了一起,出现了一种新的形态:HTAP(Hybrid Transactional/Analytical Processing,混合事务/分析处理)。
交易库:一笔付款只改几条记录(OLTP)
客户付款,系统要做三件事:扣掉他的账户余额,把订单状态改成“已支付”,再记一条付款记录。这三处改动必须一起成功,不能出现“钱扣了、订单还是待支付”。这种“要么全做、要么全不做”的要求,就是事务完整性。
一个事务里读写的记录通常就几条:查一下这个客户的余额,更新这一行订单,插入一条支付记录。它追求的是快——每个请求都在毫秒级返回,因为收银台前同时有成千上万个客户在并发下单,谁也不愿意多等。
为了支持这种“频繁地读写少量记录”,交易库把数据按行存起来:一行是一个客户、一笔订单、一条支付。要查某个客户的余额,直接定位到那一行就行。
可以把一行想成一张客户资料卡:姓名、联系方式、余额等信息都记在同一张卡上。查某个客户的余额,就找到他的那张卡,再读取其中的余额字段。
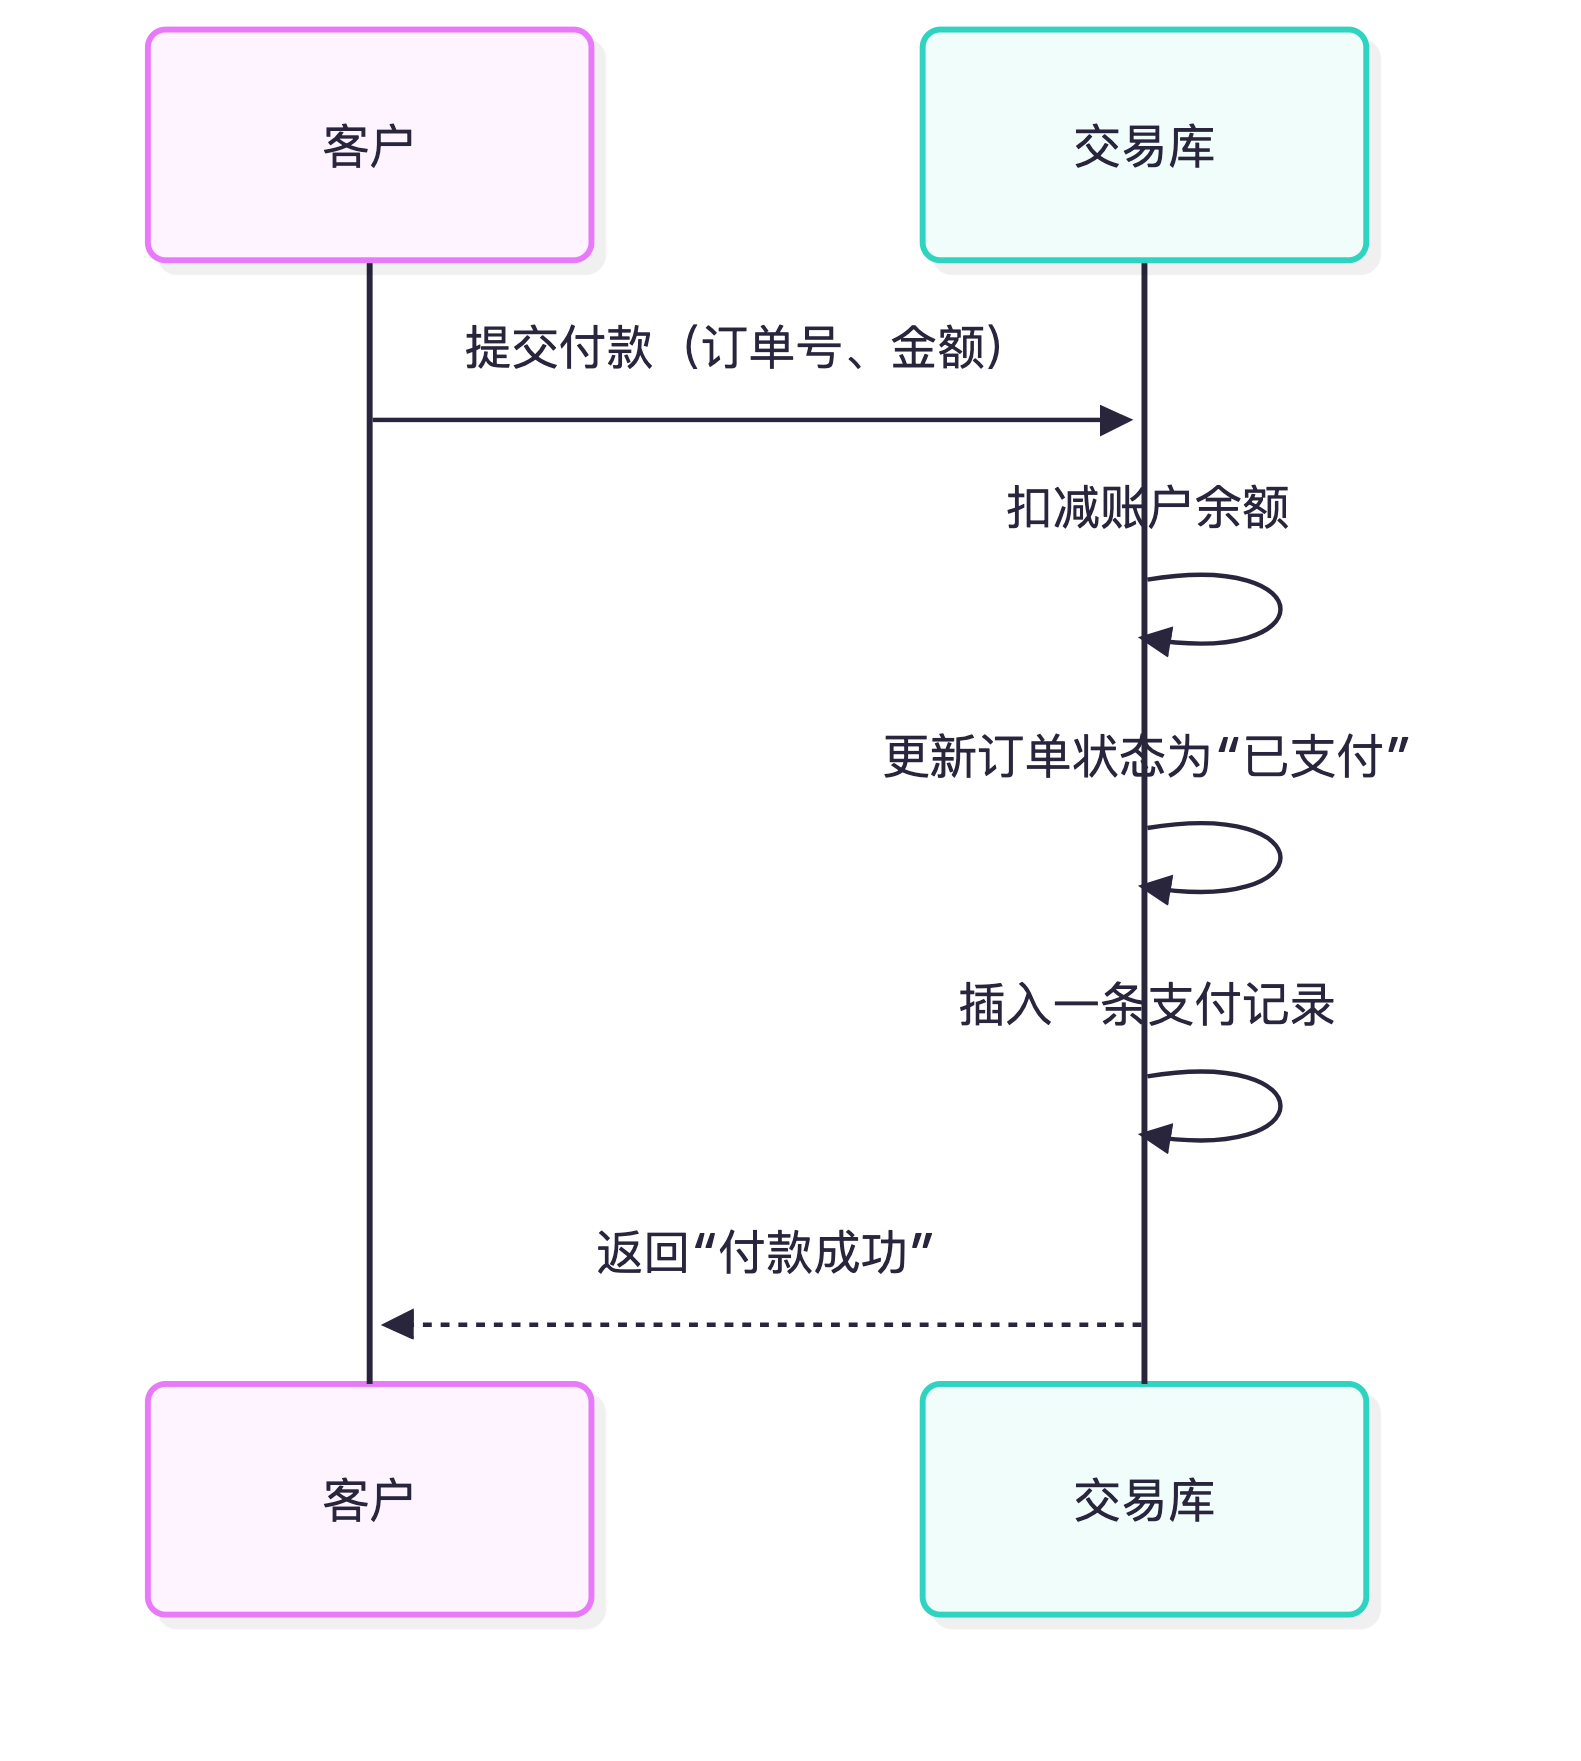
这三处改动要么一起生效,要么一起回滚。“联机”指的是系统直接接在业务线上,实时响应每一次操作;“事务”指的是上面这种“一组改动要么全成功、要么全失败”的工作单元。
分析库:按月按地区统计要扫描大范围数据(OLAP)
月底分析“过去一年每个地区每月卖了多少钱”,是另一回事。它不看某一个客户,而是把过去十二个月的所有订单翻出来,按“地区 + 月份”分组,把金额加起来。这里的访问范围是百万甚至千万行,但每一行只用到了“地区”“下单月份”“金额”这几个字段。
为了这种查询,分析库把数据按列存起来:一个字段的所有值放在一起。这样“只要金额这一列求和”时,不用把每行的无关字段也读进来,扫描量小、汇总快。
假设用纸记账:每笔订单各记一张卡,金额旁边还写着订单号、地区等信息;如果把所有订单的金额另抄在一张金额清单上,求总额时就只需沿着这张清单往下加。这里的金额清单对应金额列,集中保存同一字段的值。
交易关心的是当下这笔操作,分析关心的是跨时间的历史。要做“过去一年”的统计,十二个月前的订单数据就还得在。
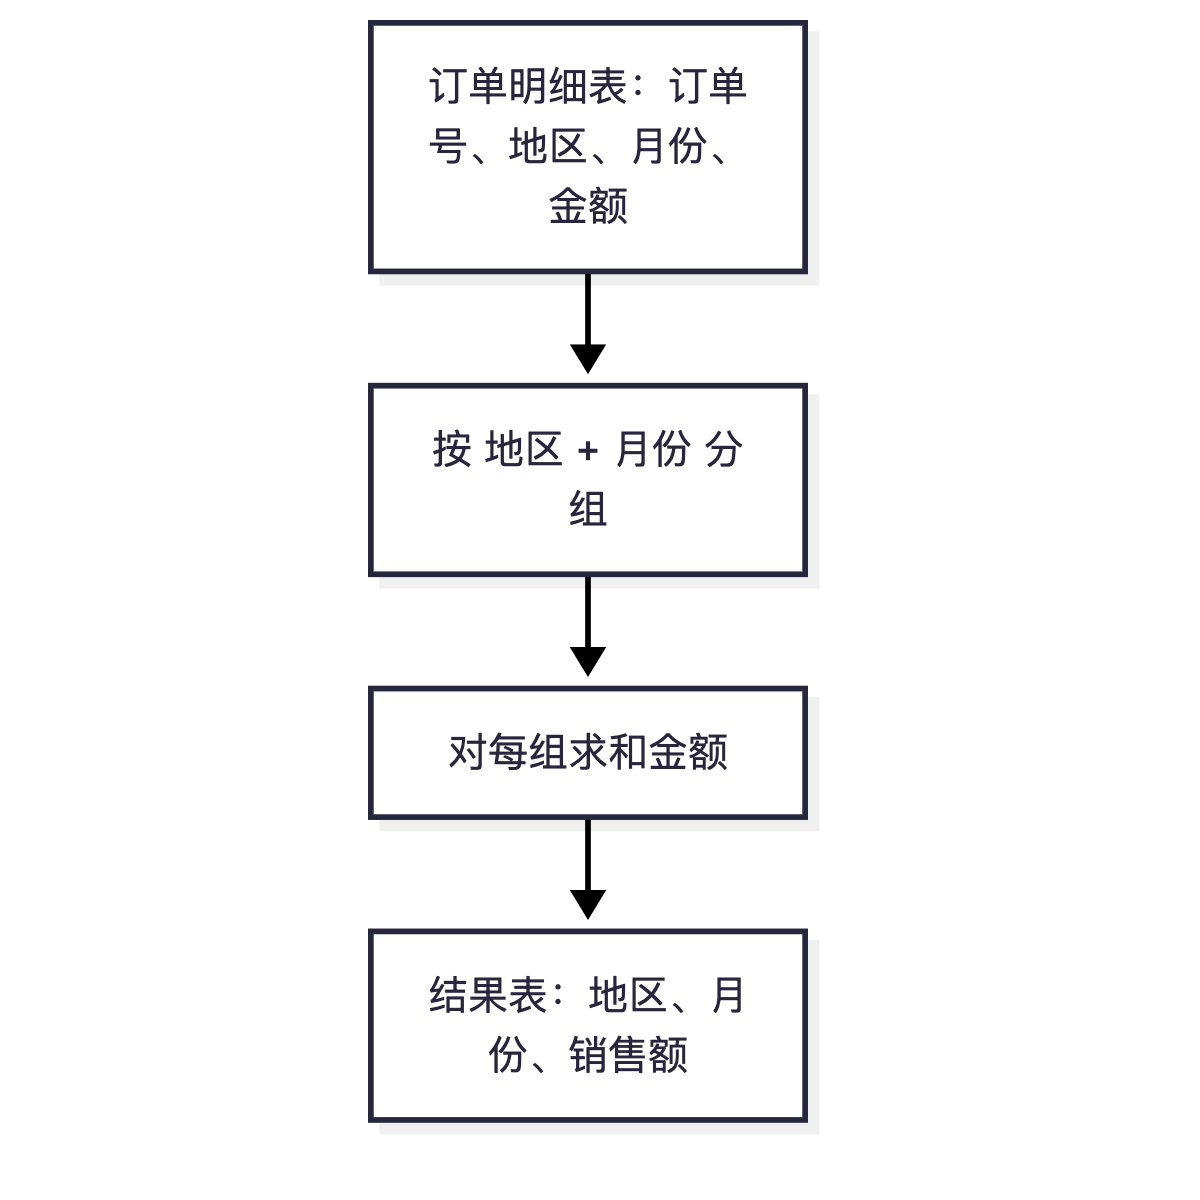
“分析”指的就是这种多维观察:按地区看、按月份看、按地区加月份一起看,然后做汇总。为了把“销售额”这种业务含义对应到具体的字段和计算规则,分析库还会维护一层语义模型,让报表直接说“销售额”,而不是让每个开发报表的人自己去猜该用哪个字段、怎么加。
用访问特征区分两类存储引擎,而不是比谁快
有人会说:交易快、分析慢,所以分成了OLTP和OLAP。这个说法不准确。
分析查询也可以做得很快:把列存在内存里、用专门的列存引擎加速,几秒甚至更短就能出结果。反过来,交易系统里也完全可以执行一句聚合,比如“查一下我这个月一共卖了多少单”。所以不能用“谁快谁慢”来分,而要看一次操作读写了多少记录、关注的是事务内的状态一致还是跨记录统计。
把两类引擎放在一起对照:
| 维度 | 交易(OLTP) | 分析(OLAP) |
|---|---|---|
| 访问范围 | 少数几条记录 | 大量记录 |
| 关注点 | 事务内的状态一致 | 跨记录的统计与分析 |
| 并发 | 高并发、短事务 | 少量长查询 |
| 响应时间 | 毫秒级 | 秒到分钟级 |
| 数据组织 | 按行存,方便定位一行 | 按列存,方便扫描一列 |
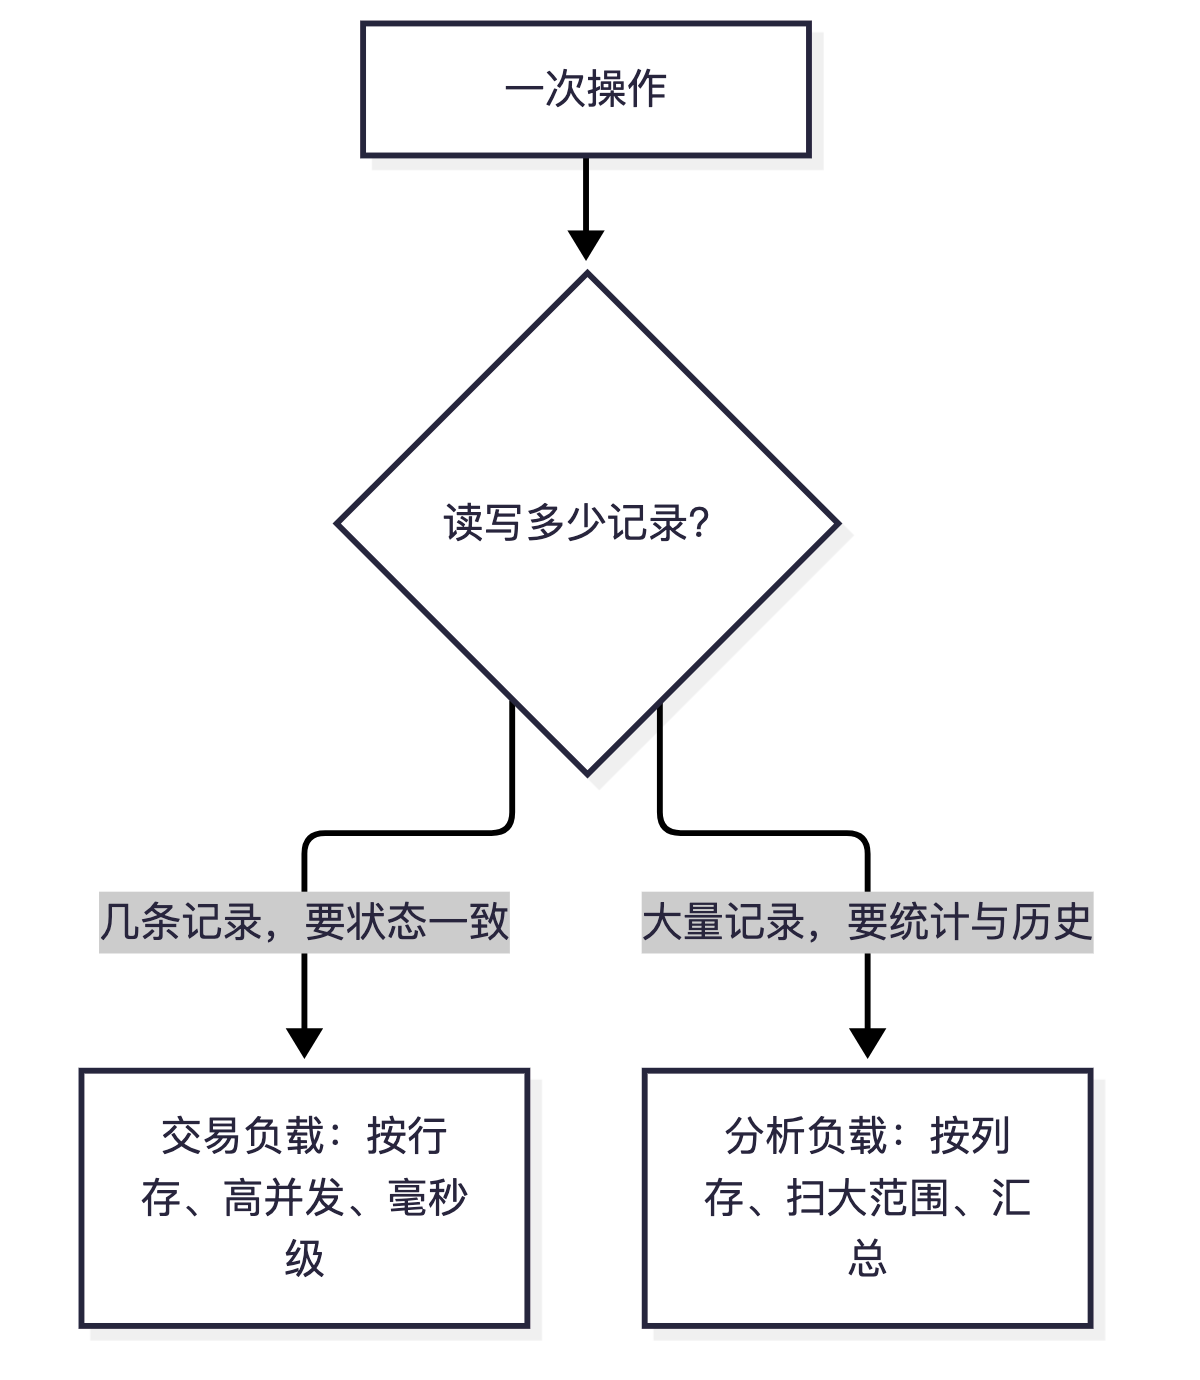
同一笔订单,付款写入要求的是状态一致——余额、订单状态、支付记录三处一起变;按月按地区汇总要求的是跨记录统计——把千千万万行金额加起来。前者是交易,后者是分析。
一套系统两样都做:HTAP 的双存储
传统做法是把这两类系统分开:交易数据先写进交易库,再定期抽取、转换、装载(ETL)到分析库,分析库才能算。这样两类负载互不干扰,代价是分析库里的数据总比交易库慢一拍——刚下的订单,可能要等一会儿才能进报表。
HTAP(Hybrid Transactional/Analytical Processing,混合事务/分析处理)想做的,是让一套系统同时把两样都干了。这个词最早由 Gartner 提出,指在一个系统里同时处理交易和分析负载,省掉中间的 ETL,缩短交易数据进入分析的延迟。
具体怎么做到?行存适合交易——定位一行快;列存适合分析——扫一列快。HTAP 系统通常为同一份数据同时维护两种存储形态:行存给交易用,列存给分析用,再把交易里的新改动同步到列存那边。有的系统把列存放在内存里(比如 Oracle、SQL Server),有的用分布式行存加列存副本(比如 TiDB),有的以列存为主、再配一个行式的增量区(比如 SAP HANA)。
以同时维护行存和列存的方式为例,可以把它想成一家店既保留每笔订单的明细卡,又按字段整理统计清单。处理某笔订单时查明细卡,汇总金额时读金额清单;明细卡上的金额改了,清单中的对应金额也得更新。两份记录对应同一笔业务数据的两种存储形态,更新清单对应把交易改动同步到分析所用的存储中。
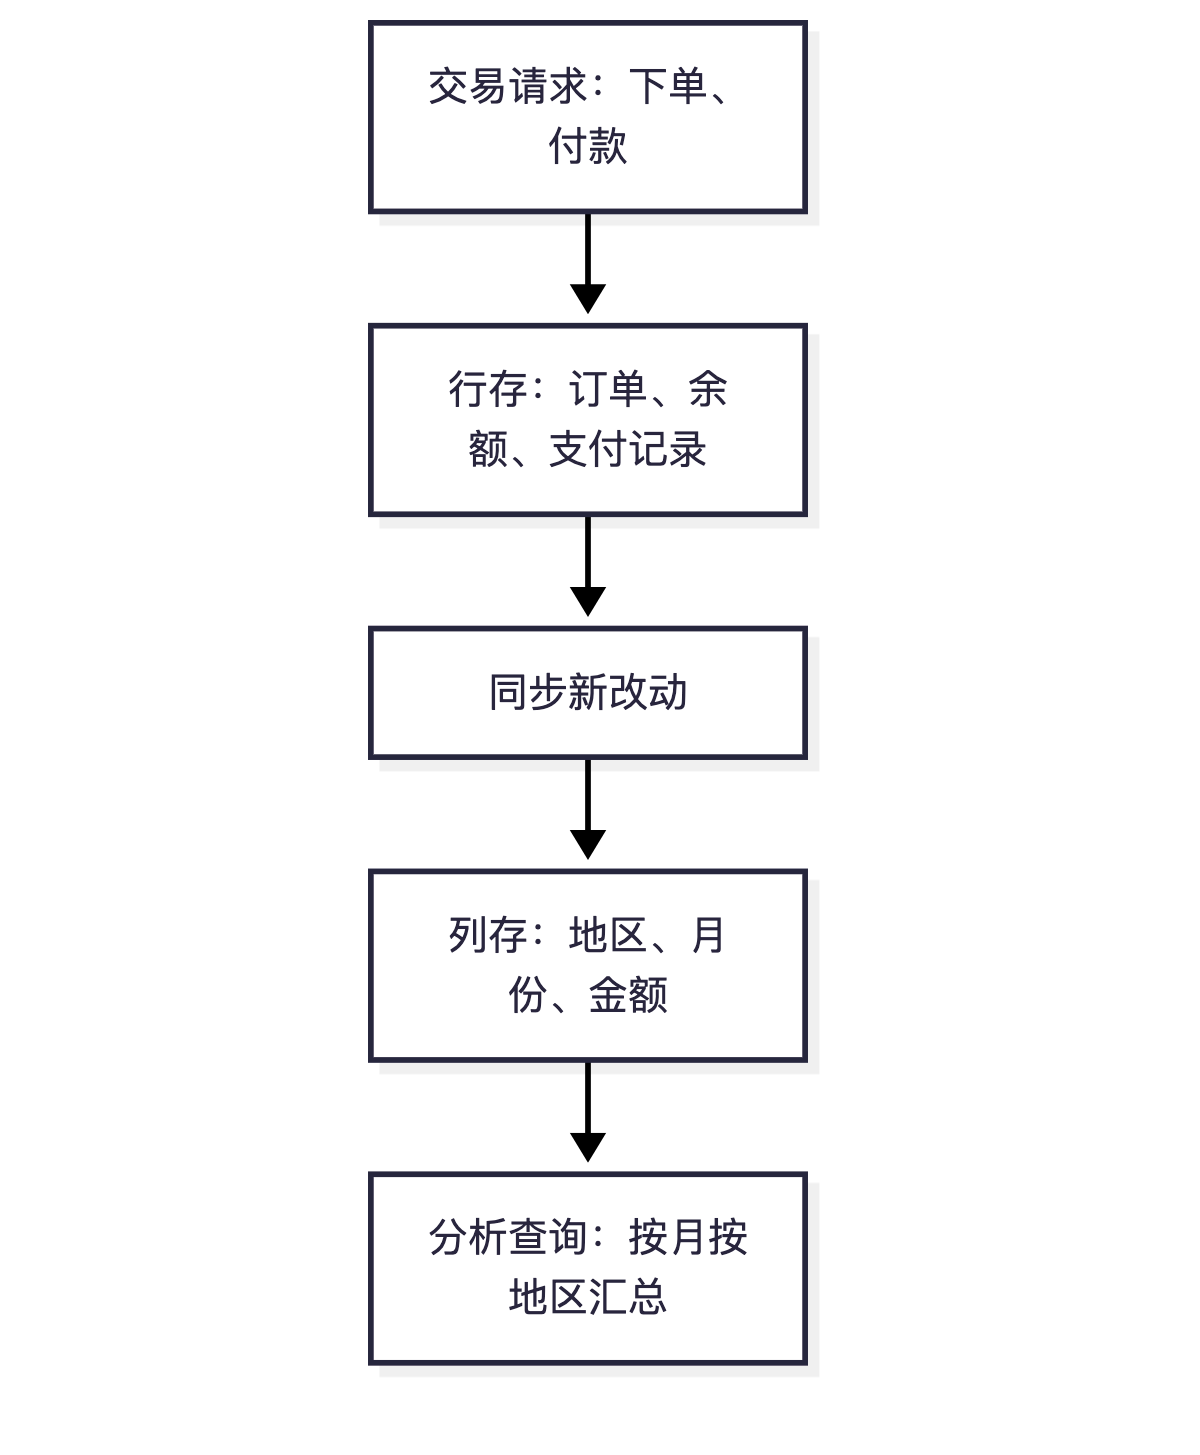
但“一套系统两样都做”不是免费的。分析要看到最新数据,就要尽快把交易改动同步到列存,同时还要考虑同步对交易性能的影响;想让分析不拖慢交易,还需要考虑两类负载的隔离。数据新鲜度和性能隔离如何权衡,要结合具体实现和业务要求判断。所以同样一套 HTAP 系统,用在“实时欺诈检测”还是“允许分钟级延迟的报表”上,取舍完全不同。
判断一个系统属于哪种引擎,看操作目的
怎么判断眼前这个系统跑的是哪类引擎?答案不是看产品名字,而是看操作目的:一次读写多少记录、关注的是事务内的状态一致还是跨记录统计。判断系统如何承载这些负载,还要看查询需要多长时间范围的数据,以及有没有把两类负载隔离开。
同一个产品可以同时支持两类能力。Oracle、SQL Server、TiDB 这些产品,既有交易引擎,也有列存分析引擎。所以不能因为“这是 TiDB”就断定它是分析库,也不能因为“它也能跑聚合”就断定它不是交易库。要看实际接进来的负载是什么、资源怎么隔离、要达到什么目标。
回到开头的例子:收银台写订单,一次改几条记录、要毫秒级返回、要状态一致,这是交易负载;财务按月按地区汇总,一次扫千万行、只看几个字段、要的是历史统计,这是分析负载。一个系统能不能扛住这两件事,取决于它的存储组织和资源分配是否适合这两种访问模式,而不是它叫什么名字。
评论