
数据库三范式:如何减少重复维护与数据异常
数据库三范式是关系数据库设计中逐步约束表结构的规则:第一范式字段原子性,第二范式处理非主属性对主键的部分依赖,第三范式进一步处理非主属性的传递依赖。它们要解决的实际问题是:相同属性在多条记录中重复保存,更新时容易出现差异,插入和删除时也可能出现无法插入和删除有用信息的问题。
数据异常与函数依赖:为什么需要范式
假设要保存一个学期的选课信息:每名学生当前只属于一个院系,每名学生对每门课程至多有一条选课记录,课程编号确定课程名称。学生姓名、院系名称都允许重名,成绩属于某名学生的一条选课记录。
如果在每条选课记录中都保存学生姓名和院系名称,一名学生选了十门课,就要重复保存十次相同的信息。这会产生三类数据异常:
- 更新异常:院系更名,只修改部分选课记录,同一院系就出现两个名称。
- 插入异常:新学生尚未选课,但表要求每条记录必须有课程编号,学生信息便无法独立登记。
- 删除异常:删除一名学生最后一条选课记录时,也把唯一保存的该学生信息删除了。
这就像每次借书时都在登记簿上抄写读者住址:读者搬家后,得修改多处旧登记,漏改一处就会留下矛盾。单独维护读者资料,借书时只登记读者编号,就能减少这种重复维护。数据库拆表也是把可独立维护的信息分开保存,再通过编号关联。
判断哪些属性可以分开,需要描述字段之间的函数依赖。记作 X → Y,含义是:在所有符合业务规则的合法记录中,只要两条记录的X值相同,Y值就必须相同。X和Y都可以是字段集合。它表达业务约束;
根据上述业务规则,字段之间存在以下函数依赖。
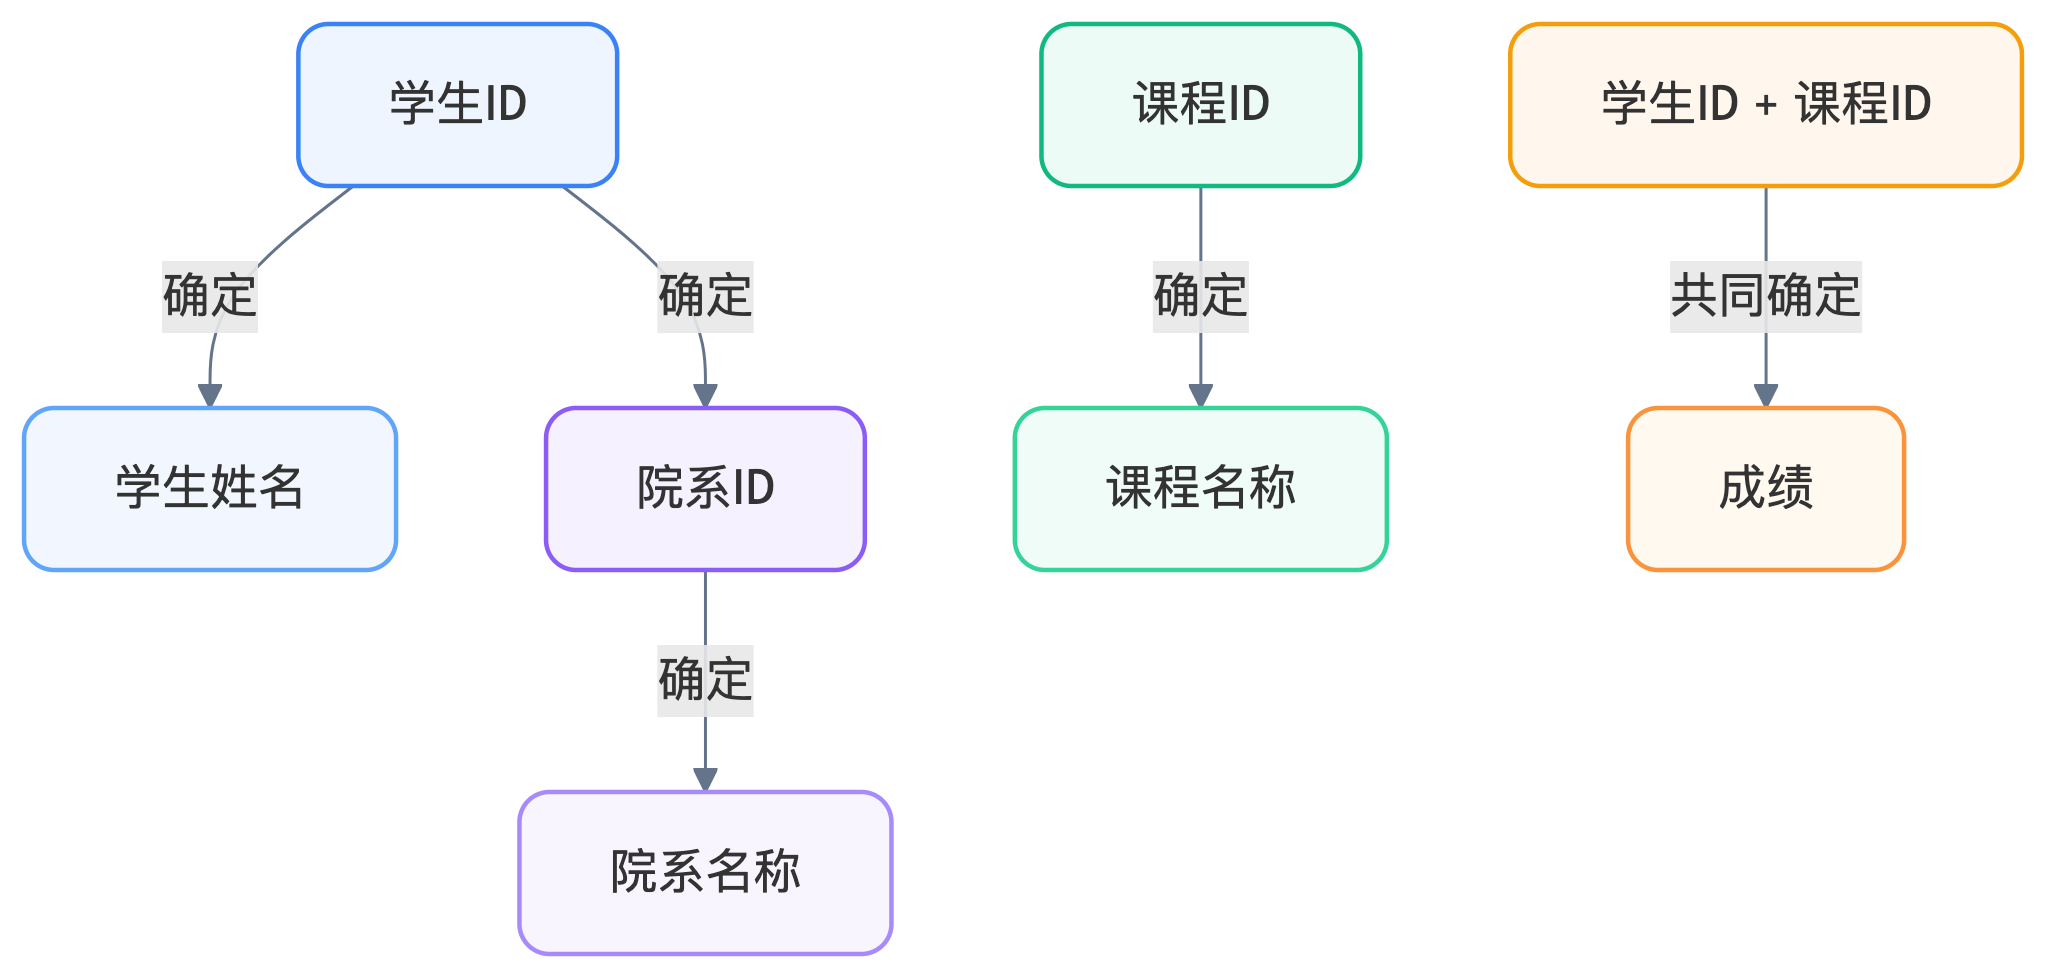
学生ID可以确定学生姓名,却不能单独确定成绩,因为同一学生选了多门课程;课程ID也不能单独确定成绩,因为一门课有多名学生。
能唯一确定一条记录的一组字段叫主键;主键可以包含多个字段,属于主键中任一字段的属性叫主属性,其余叫非主属性。对上述选课记录,主键是“学生ID+课程ID”。
第一范式:字段取原子值,消除重复组
如果把学生S01的选课保存在一个字段里,写成“C01数据库,C02数据仓库”,一个字段就装入了多门课。查询是否选择C01、为各门课登记成绩,都要先解析这段列表。
| 学生ID | 学生姓名 | 院系ID | 院系名称 | 课程ID | 课程名称 | 成绩 |
|---|---|---|---|---|---|---|
| S01 | 小林 | D01 | 信息学院 | C01 | 数据库,数据仓库 | |
| S02 | 小周 | D01 | 信息学院 | C01 | 数据库 |
这像购物清单:如果要分别记录每种商品的购买数量,把“苹果、牛奶”合写在同一项里,就不便填写各自的数量;分成两项后,每项就能对应自己的数量。
第一范式(1NF)要求字段取值为原子值,并消除重复组。 对需要分别管理的多门课程,可以改成每条记录保存一名学生对一门课程的选课信息:
| 学生ID | 学生姓名 | 院系ID | 院系名称 | 课程ID | 课程名称 | 成绩 |
|---|---|---|---|---|---|---|
| S01 | 小林 | D01 | 信息学院 | C01 | 数据库 | 90 |
| S01 | 小林 | D01 | 信息学院 | C02 | 数据仓库 | 85 |
| S02 | 小周 | D01 | 信息学院 | C01 | 数据库 | 88 |
也不能用“课程1、课程2、课程3”不断加列来代替逐课记录;那仍是重复组,新增课程还会迫使表结构变化。
“原子”按字段所表示的含义判断,不是把字符串一直拆到单个汉字。学生姓名即使包含姓和名,也可以作为一个姓名值保存;
改成单值后,成绩能归属于明确的选课记录,但“小林”和“信息学院”仍反复出现。1NF没有解决这些属性被重复保存的问题。
第二范式:消除非主属性对主键的部分依赖
第二范式(2NF)要求满足1NF,并且每个非主属性都完全函数依赖于每一个主键。 “完全”是指:去掉主键中的任何字段,剩余字段都不能继续确定该非主属性;若主键的某个真子集已经足够,就存在部分函数依赖。
对上表的复合主键“学生ID+课程ID”,各字段的依赖不同:
| 非主属性 | 实际决定因素 | 判断 |
|---|---|---|
| 学生姓名、院系ID、院系名称 | 学生ID | 只需主键的一部分 |
| 课程名称 | 课程ID | 只需主键的一部分 |
| 成绩 | 学生ID+课程ID | 需要完整主键 |
知道S01就能知道姓名是小林,再提供课程ID不会帮助确定姓名;但只知道S01,无法判断要取90分还是85分。姓名存在部分依赖,成绩则完全依赖于复合主键。
可以想象同一影厅的售票清单:知道座位编号,就能查出它在第几排,不必再问是哪一场电影;但要查这个座位卖给了谁,就得同时知道场次和座位编号。同一个座位在不同场次可能卖给不同观众,只知道场次也不能确定具体座位的购票人。如果每张票都抄写座位所在排数,就反复记录了座位本身的信息。
因此,把学生属性、课程属性和选课事实分开保存:
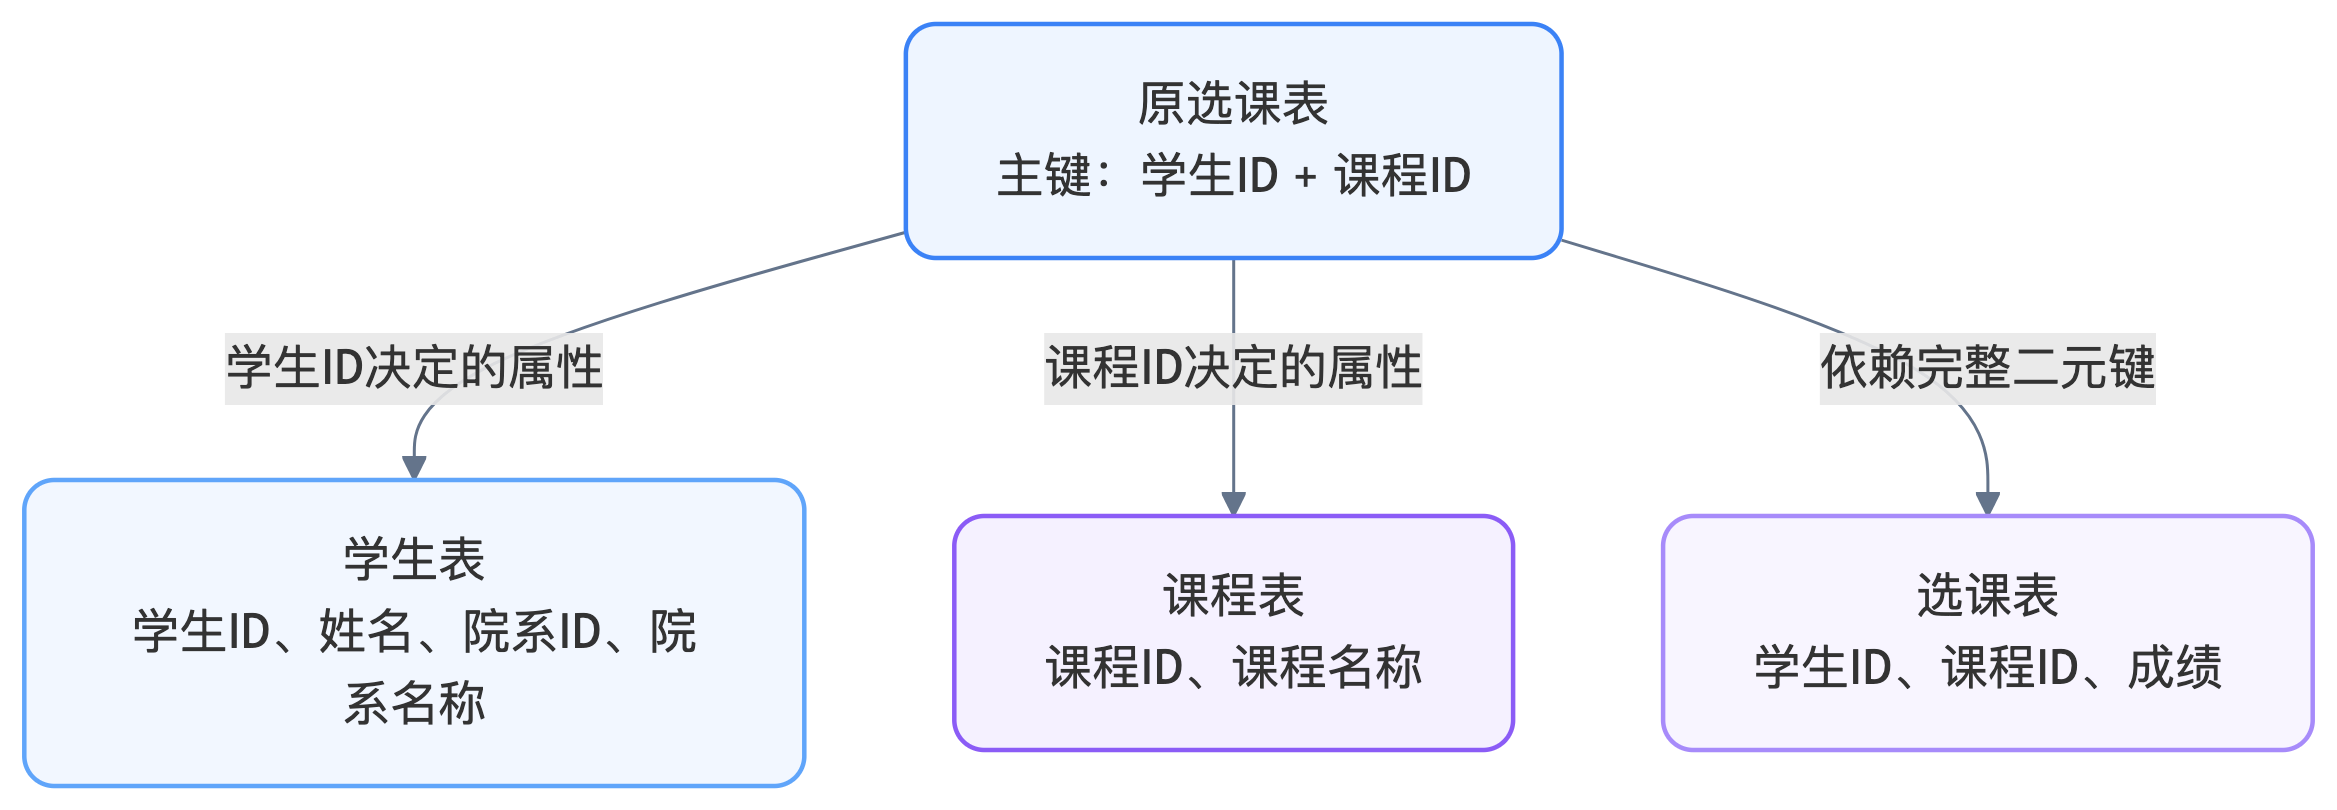
学生表保留两条记录:(S01, 小林, D01, 信息学院)、(S02, 小周, D01, 信息学院);课程表保留(C01, 数据库)和(C02, 数据仓库)。选课表变为:
| 学生ID | 课程ID | 成绩 |
|---|---|---|
| S01 | C01 | 90 |
| S01 | C02 | 85 |
| S02 | C01 | 88 |
现在修改小林的姓名,只需修改学生表中S01的一条记录;新课程也可以先登记到课程表,无须等待有人选课。选课表仍保留三条事实,并没有按学生去重而丢掉课程或成绩。
第三范式:消除非主属性的传递依赖
拆分后的学生表以学生ID为主键,已经满足2NF,但两名学生的记录仍保存了同一个“信息学院”。院系更名依然可能漏改,因为这里还有:
学生ID → 院系ID → 院系名称
院系ID能确定院系名称,却不能确定唯一学生;一个院系可以有多名学生。因此,院系ID不是学生表的组合键,院系名称又是非主属性,形成需要处理的传递函数依赖。
想象给家里的藏书逐本编号,在清单上记下每本书所在的书柜编号和书柜位置。几本书都放在客厅的同一个书柜里,清单就会反复写着“客厅”;把整个书柜搬到书房后,每本书对应的位置都要改成"书房",漏改一本就会留下旧位置。如果藏书清单只记书柜编号,另用一份书柜清单记录位置,搬柜子时就只需改一处。书的编号先确定书柜编号,书柜编号再确定位置。
第三范式(3NF)在2NF的基础上,消除非主属性对主键的这类传递依赖。 将院系名称交给院系表维护,学生表保留院系ID:
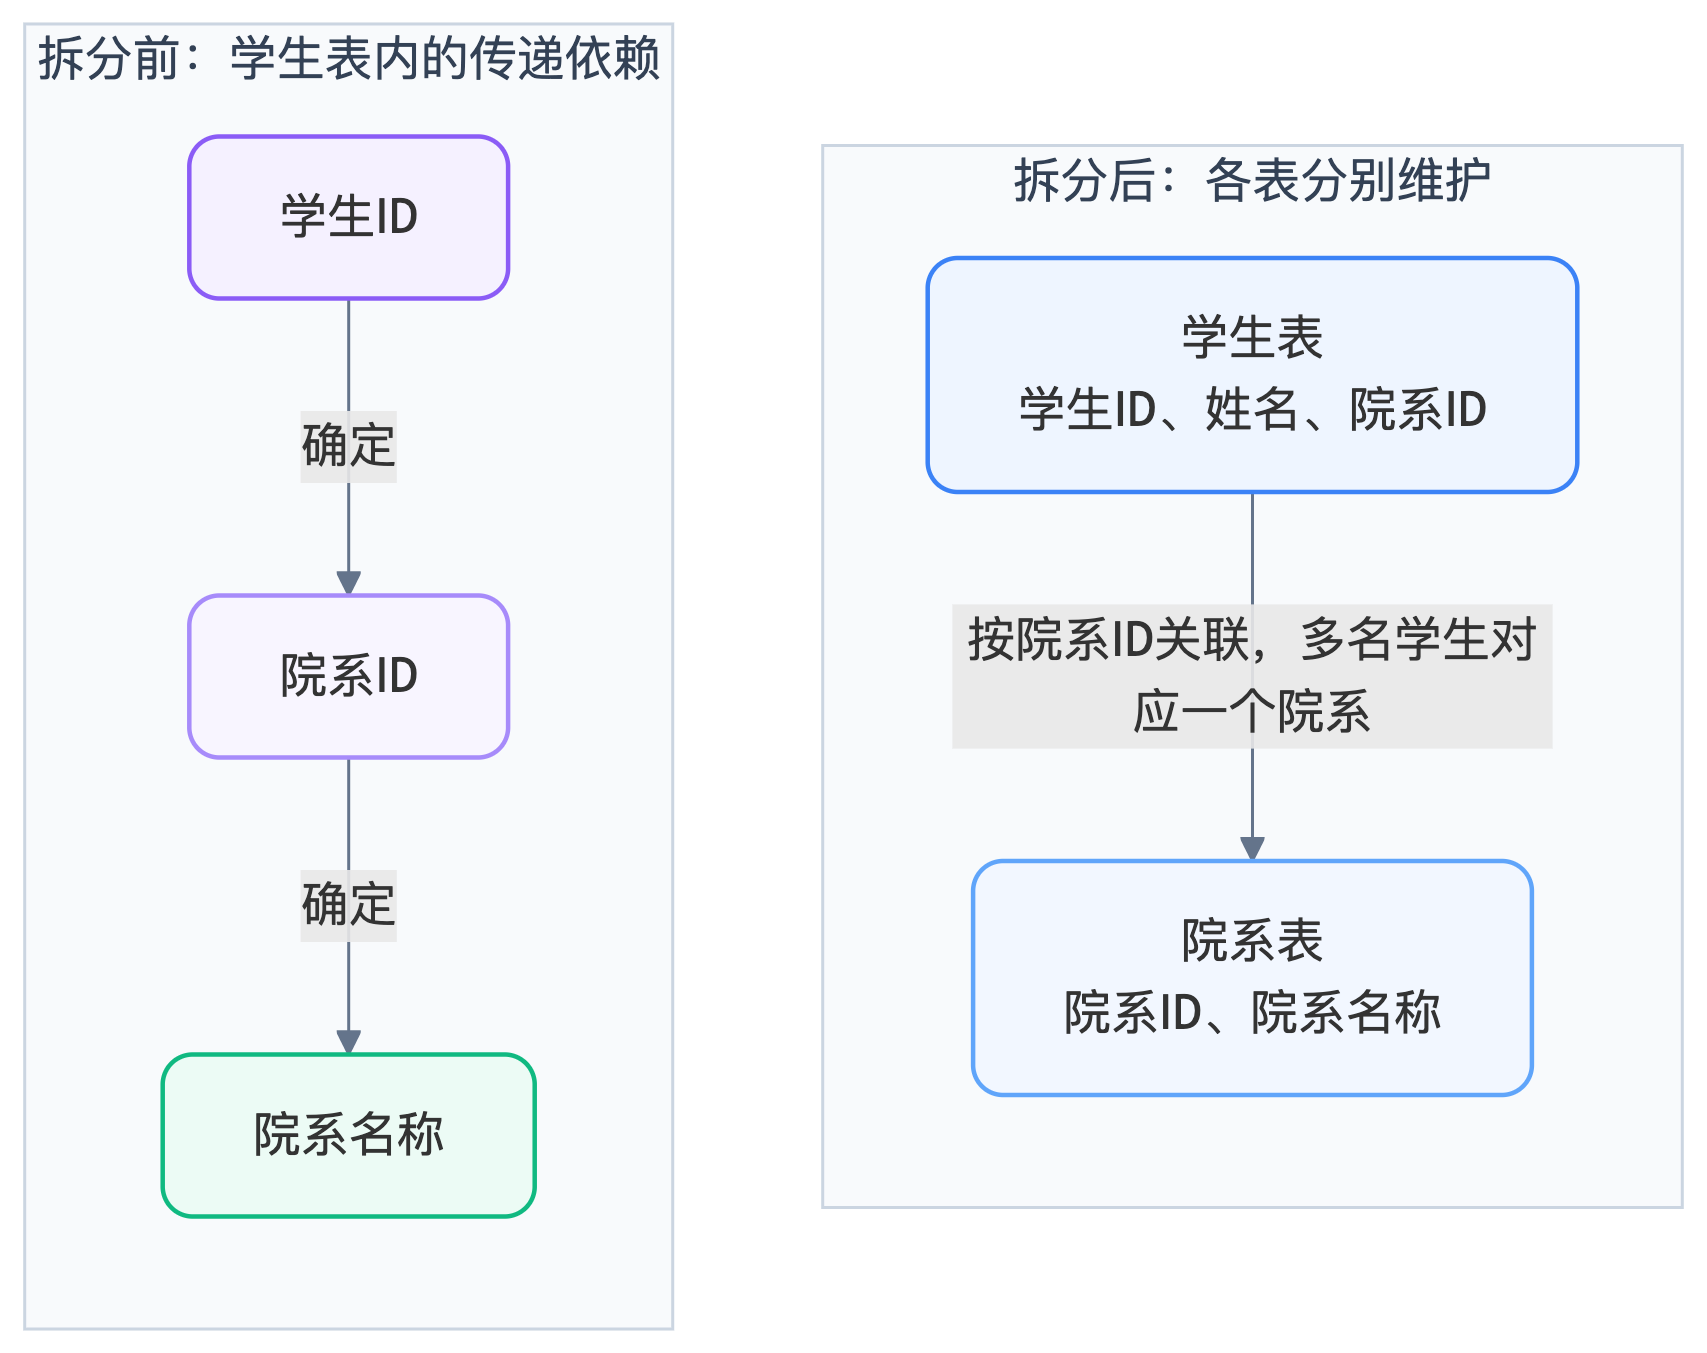
图中“拆分前”区域展示传递依赖,“拆分后”区域展示表的关联关系。拆分后的学生表为(S01, 小林, D01)、(S02, 小周, D01);院系表为(D01, 信息学院)。此前的课程表、选课表继续保留。
当编号为D01的院系更名为“计算学院”时,修改院系表的一条记录即可。删除某名学生的选课记录,也不会同时删除学生和院系资料。
拆表后怎样恢复原来的信息?从选课记录(S01, C01, 90)出发,按S01匹配学生表,得到小林和D01;按D01匹配院系表,得到信息学院;按C01匹配课程表,得到数据库。这就恢复了原表的第一条记录,另外两条记录也能按同样方式恢复。
关键在于每个被引用的编号都存在,而且在对应资料表中唯一。若D01在院系表中有两条记录,一条选课记录可能匹配成两条;若D01缺失,内关联会丢掉该条记录。正确分解既要保留信息,也要保持依赖约束,不能只看表的数量变多了。
更一般地,3NF的正式条件是:对关系中每一条成立的非平凡函数依赖X → A,X是组合键,或者A是主属性。A不属于X时,这条依赖才叫非平凡依赖。本例中院系ID → 院系名称两项条件都不满足,因此违反3NF。
范式应用中的业务约束、查询成本与冗余维护
范式判断首先依赖正确的业务规则。如果要保存多个学期,或允许同一学生多次修读同一课程,“学生ID+课程ID”就可能无法唯一标识选课,需要把学期或修读次数等实际区分条件纳入键。不能从当前三条记录反推出未来所有数据的约束。
同样,当前院系名称与选课发生时的院系名称也可能发生变化。如果要求保留历史名称,就需要记录相应的时间或版本信息;直接用今天的院系表关联过去的选课记录,会得到当前名称。是否允许重复保存某个字段,要先确定它表达哪一个时间范围的值。
频繁修改学生、课程和院系资料时,分别维护这些数据能减少重复修改。查询包含学生姓名、课程名称、院系名称和成绩的完整清单,则要关联多张表,可能增加查询成本。不能仅因满足3NF,就认为查询一定更快。
如果为特定查询主动保存冗余字段,就需要明确权威数据来自哪张表、何时同步,以及源数据改变后如何更新已有副本。三范式帮助识别哪些信息被重复维护、会产生什么异常;保留冗余时,这些维护责任仍然存在。
这像组织家庭出游:联系人号码平时统一保存在组织者的通讯录里,出发前再抄到纸上,发给每个人,途中需要联系时就能直接查表。假如有人换了号码,只修改组织者的通讯录,其他人照着旧表拨号,仍然联系不上;还得把新号码通知大家,让各自的联系表一起更新。纸质副本方便随手查阅,却也多了一项维护责任。
评论